Cyber : L'IA accélère l'évaluation des vulnérabilités
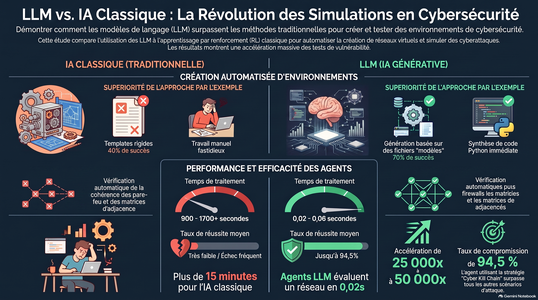
Face aux attaques sophistiquées, les méthodes traditionnelles de simulation cyber souffrent de lenteur et de coûts élevés. L'intégration des modèles de langage (LLM) automatise la génération d'environnements dynamiques via des schémas YAML de référence, tout en surmontant les erreurs de configuration réseau.
Sur le plan tactique, les agents d'attaque pilotés par LLM atteignent un taux de succès allant jusqu'à 94,5 % en gérant l'infiltration multi-étapes. Comparativement à l'apprentissage par renforcement classique, souvent sujet à l'échec par récompense éparse, les LLM accélèrent l'évaluation des risques de 25 000× à 50 000×. L'avenir réside dans l'intégration du RAG pour aligner ces simulations avec des CVE réelles.
Sur le plan tactique, les agents d'attaque pilotés par LLM atteignent un taux de succès allant jusqu'à 94,5 % en gérant l'infiltration multi-étapes. Comparativement à l'apprentissage par renforcement classique, souvent sujet à l'échec par récompense éparse, les LLM accélèrent l'évaluation des risques de 25 000× à 50 000×. L'avenir réside dans l'intégration du RAG pour aligner ces simulations avec des CVE réelles.