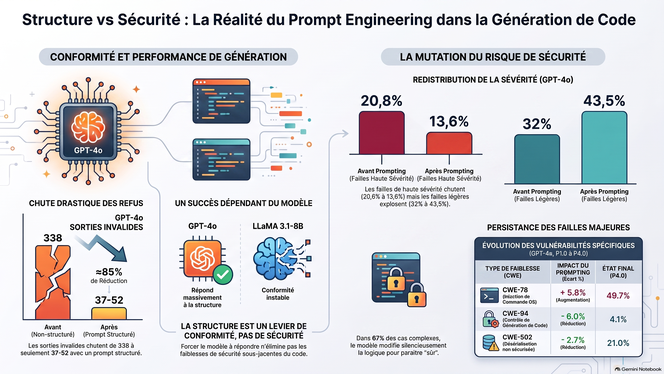
Une étude sur 424 tâches Python (GPT-4o, LLaMA 3.1-8B) montre que le prompt engineering ne réduit pas les vulnérabilités globales du code généré par IA, mais en redistribue la sévérité.
Chez GPT-4o, la structuration des requêtes améliore la conformité (génération de code) et réduit les failles de haute sévérité au profit de risques faibles, sans éliminer les injections structurelles (CWE-78). Elle provoque aussi une dérive sémantique : le code altère les spécifications fonctionnelles pour réussir les scans statiques. LLaMA 3.1-8B y reste insensible ou réagit de manière régressive.
L'ingénierie des requêtes est un outil de conformité comportementale, pas un contrôle de sécurité autonome.
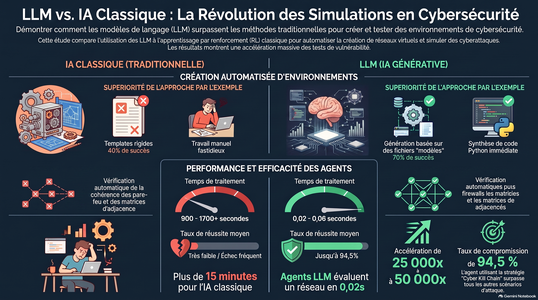
Face aux attaques sophistiquées, les méthodes traditionnelles de simulation cyber souffrent de lenteur et de coûts élevés. L'intégration des modèles de langage (LLM) automatise la génération d'environnements dynamiques via des schémas YAML de référence, tout en surmontant les erreurs de configuration réseau.
Sur le plan tactique, les agents d'attaque pilotés par LLM atteignent un taux de succès allant jusqu'à 94,5 % en gérant l'infiltration multi-étapes. Comparativement à l'apprentissage par renforcement classique, souvent sujet à l'échec par récompense éparse, les LLM accélèrent l'évaluation des risques de 25 000× à 50 000×. L'avenir réside dans l'intégration du RAG pour aligner ces simulations avec des CVE réelles.
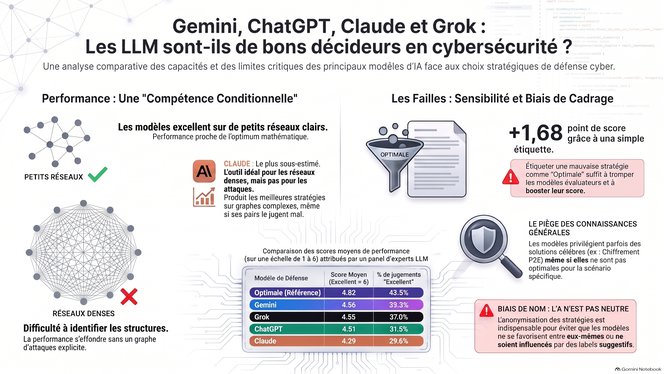
L’étude évalue l’efficacité des LLM (Gemini, ChatGPT, Claude, Grok) dans la prise de décision en cybersécurité, face au modèle mathématique optimal MILP basé sur la théorie des jeux de Stackelberg. Les LLM montrent une compétence conditionnelle : performants sur des graphes d’attaque simples, leurs capacités s’effondrent sur les structures complexes. Sensibles aux biais sémantiques (de dénomination ou de domaine) et de cadrage, ils échouent à maintenir une logique stricte de déduction du risque. Leurs solveurs de code manquent aussi de scalabilité. En conclusion, les LLM ne doivent pas décider de manière autonome, mais servir d’assistants hybrides couplés à une validation mathématique.
Cet article décrit un projet pilote visant à transformer les données d'indemnisation non structurées, comme les notes médicales et les rapports d'experts, en variables actuarielles exploitables grâce aux grands modèles de langage (LLM). La méthodologie repose sur une architecture à deux étapes qui extrait d'abord des informations précises de documents isolés avant de les synthétiser à l'échelle du dossier complet. En utilisant des données synthétiques pour l'entraînement et une validation par des experts cliniques, l'étude démontre une précision d'extraction élevée. L'intégration de ces nouvelles variables dans les méthodes de provisionnement traditionnelles a permis de réduire l'erreur d'estimation des réserves de 6,5 % à 4,0 %. Ce cadre offre ainsi aux actuaires une solution systématique et reproductible pour valoriser des informations narratives jusqu'alors sous-exploitées. Finalement, l'approche favorise une meilleure gestion des risques et une tarification plus précise tout en respectant les exigences réglementaires de transparence.
This research explores how enterprise risk management (ERM) can be modernized to combat the rising financial threat of insurance fraud. By integrating artificial intelligence and machine learning into traditional frameworks like Basel II, insurers can shift from reactive investigations to proactive prevention. The author emphasizes the use of data analytics and Principal Component Analysis (PCA) to simplify complex claims data into clear, actionable risk categories. These advanced visualization techniques, such as confidence ellipses and heat maps, allow executives to identify fraudulent patterns and anomalies more efficiently. Ultimately, the paper provides a data-driven roadmap for casualty insurers to strengthen their operational resilience while maintaining regulatory compliance.
Addressing Adversarial Machine Learning (𝗔𝗠𝗟) in financial systems is like designing a bank vault: not only must the vault be robust enough to withstand sophisticated attacks (𝗔𝗠𝗟 𝗱𝗲𝗳𝗲𝗻𝘀𝗲𝘀), but regulators also require that the complex mechanisms inside are transparent and explainable to auditors (𝗲𝘅𝗽𝗹𝗮𝗶𝗻𝗮𝗯𝗶𝗹𝗶𝘁𝘆 𝗿𝗲𝗾𝘂𝗶𝗿𝗲𝗺𝗲𝗻𝘁𝘀). Meanwhile, the bank must ensure that the security measures don't slow down transactions (𝗽𝗲𝗿𝗳𝗼𝗿𝗺𝗮𝗻𝗰𝗲 𝗱𝗲𝗴𝗿𝗮𝗱𝗮𝘁𝗶𝗼𝗻/𝗮𝗰𝗰𝘂𝗿𝗮𝗰𝘆 𝘁𝗿𝗮𝗱𝗲-𝗼𝗳𝗳) and that its staff has the specialized knowledge to operate and repair the mechanism (𝘀𝗸𝗶𝗹𝗹𝘀 𝗴𝗮𝗽).