Cyberdéfense autonome : La puissance des architectures hiérarchiques LLM+LLM
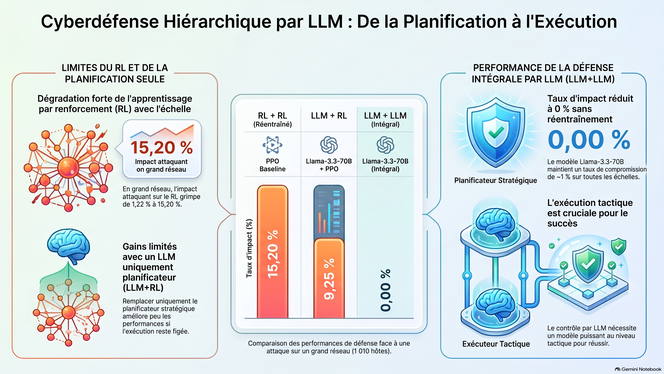
Cet article évalue la robustesse d'agents de cyberdéfense autonomes face au passage à l'échelle (jusqu'à 1 010 hôtes) sans réentraînement. Là où l'apprentissage par renforcement (RL) s'effondre en raison d'un sur-couplage à la topologie d'origine, les grands modèles de langage (LLM) à poids gelés (frozen) surmontent cette limite.
Toutefois, utiliser un LLM pour la seule planification stratégique (LLM+RL) échoue car l'exécuteur RL reste un goulot d'étranglement. Seule une architecture intégralement pilotée par LLM (LLM+LLM) garantit l'invariance d'échelle. Les grands modèles généralistes (70B) surpassent les modèles spécialisés, dont le fine-tuning altère parfois le raisonnement logique global.
Toutefois, utiliser un LLM pour la seule planification stratégique (LLM+RL) échoue car l'exécuteur RL reste un goulot d'étranglement. Seule une architecture intégralement pilotée par LLM (LLM+LLM) garantit l'invariance d'échelle. Les grands modèles généralistes (70B) surpassent les modèles spécialisés, dont le fine-tuning altère parfois le raisonnement logique global.