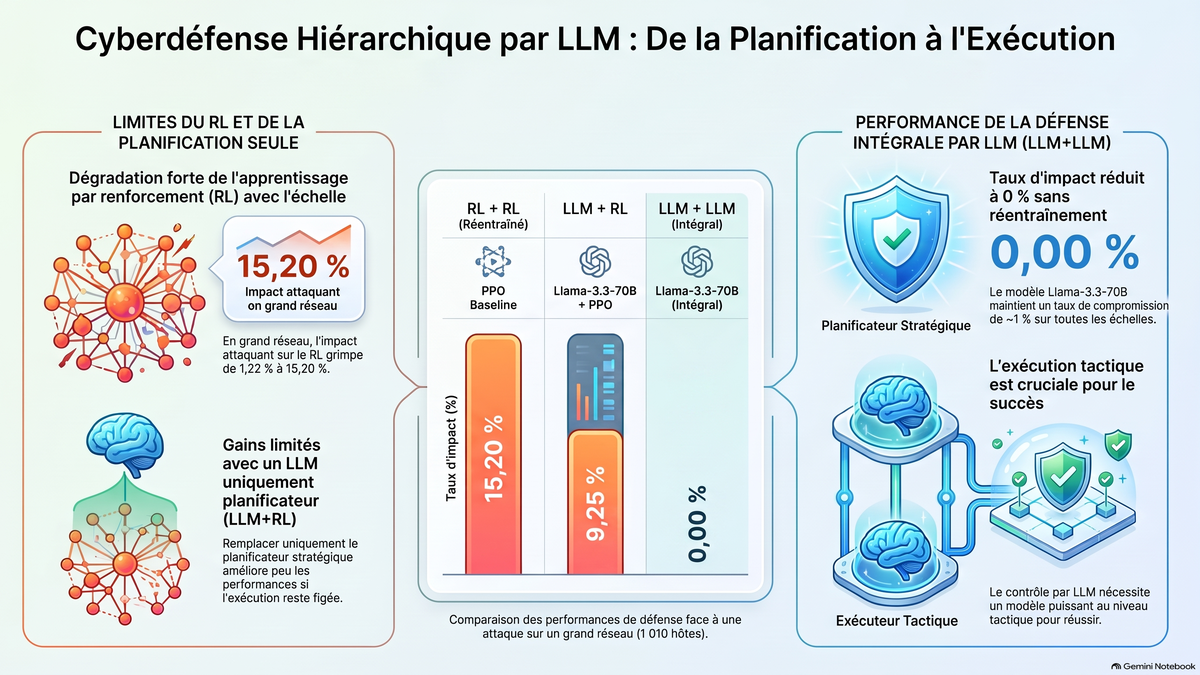
Cyberdéfense autonome : La puissance des architectures hiérarchiques LLM+LLM
IA autonome et cyberdéfense hiérarchique : Évaluation de la robustesse des modèles LLM sans réentraînement face au changement d'échelle
Source: Doppalapudi, H., Bastian, N. D., & Shah, A. (2026). Towards hierarchical cyber defense with large language models: From planning to execution. arXiv.
Sommaire : Cet article évalue la robustesse d'agents de cyberdéfense autonomes face au passage à l'échelle (jusqu'à 1 010 hôtes) sans réentraînement. Là où l'apprentissage par renforcement (RL) s'effondre en raison d'un sur-couplage à la topologie d'origine, les grands modèles de langage (LLM) à poids gelés (frozen) surmontent cette limite.
Toutefois, utiliser un LLM pour la seule planification stratégique (LLM+RL) échoue car l'exécuteur RL reste un goulot d'étranglement. Seule une architecture intégralement pilotée par LLM (LLM+LLM) garantit l'invariance d'échelle. Les grands modèles généralistes (70B) surpassent les modèles spécialisés, dont le fine-tuning altère parfois le raisonnement logique global.
1. Contexte et limites des approches par Apprentissage par Renforcement (RL)
La cyberdéfense autonome repose sur des agents chargés d'exécuter des prises de décisions séquentielles au sein d'architectures réseau d'entreprise dynamiques et hétérogènes. Ce problème de contrôle s'inscrit formellement dans le cadre d'un processus de décision Markovien partiellement observable (POMDP), défini par le 7-uplet :
M = (S, A, P, R, Ω, O, γ)
Dans cette formalisation, S représente l'état caché de l'environnement (incluant la topologie physique et logique du réseau, le statut de compromission individuel de chaque hôte, la progression de l'attaquant dans la chaîne d'attaque et les modifications défensives actives), A désigne l'espace des actions du défenseur, et P(s' | s, a) constitue le noyau de transition d'état conjointement induit par les actions défensives et le comportement de l'attaquant. La fonction de récompense R : S × A × S → ℝ évalue la qualité des décisions, tandis que Ω définit l'espace des observations et O(o | s) le noyau d'observation stochastique. L'agent défenseur ne dispose d'aucun accès direct à l'état réel s_t ∈ S ; il opère exclusivement à partir d'observations partielles et bruitées o_t ~ O(· | s_t) fournies par les détecteurs et sous-systèmes de sécurité. Le facteur de remise γ ∈ (0, 1) garantit la convergence des gains cumulés à horizon infini.
L'apprentissage par renforcement (RL) classique offre une formulation rigoureuse pour l'optimisation de telles politiques défensives. Toutefois, les agents entraînés par RL souffrent d'un couplage structurel strict avec la topologie, le plan d'adressage et l'échelle spécifique du réseau ayant servi à leur entraînement. Lors de l'extension de l'infrastructure ou d'une modification topologique, les politiques apprises échouent à généraliser en raison de la rigidité des espaces d'états et d'actions vectoriels. L'adaptation de la défense autonome à une nouvelle échelle exige alors un réentraînement complet du modèle, engendrant un coût computationnel substantiel et une indisponibilité opérationnelle incompatible avec les contraintes d'exploitation des réseaux industriels.
Pour surmonter cette dépendance au réentraînement, l'émergence des grands modèles de langage (LLM) exploités en mode frozen (poids gelés, sans mise à jour paramétrique) et zero-shot offre un paradigme alternatif. En tirant parti des capacités de raisonnement abstrait acquises lors de leur préentraînement massif, ces modèles permettent de traiter des représentations textuelles ou structurées d'environnements inconnus et d'assurer un contrôle réactif sans nécessiter d'ajustement spécifique à la tâche.
2. Architecture de contrôle hiérarchique : Du planificateur à l'exécuteur
Afin de contenir la complexité décisionnelle liée à la taille des réseaux, le système adopte une décomposition hiérarchique contrôleur-agnostique. Cette architecture sépare formellement la planification stratégique globale de l'exécution tactique locale.
Conformément à la structure de cette architecture de contrôle, le flux logique d'information et de décision s'articule selon la séquence opérationnelle suivante :
Extraction de l'observation réseau : Les alertes bruitées et les télémétries brutes sont agrégées sous forme d'indicateurs synthétiques au niveau des sous-réseaux et des hôtes.
Planification stratégique (π_hi) : Le planificateur stratégique reçoit une représentation synthétique au niveau sous-réseau o^hi et sélectionne un objectif sous-réseau g_t ∈ G = {1, …, B} pour un horizon temporel fixe de k = 5 étapes d'environnement (g_t = g_⌊t/k⌋). Cette abstraction temporelle introduit un facteur de remise effectif de γ^k entre deux décisions stratégiques successives.
Transmission du conditionnement : L'objectif g_t est transmis à l'exécuteur sous la forme d'un vecteur d'engagement one-hot.
Exécution tactique (π_lo) : Conditionné conjointement par la télémétrie courante o_t et le vecteur d'objectif g_t, l'exécuteur tactique sélectionne à chaque étape t une action primitive a_t = (τ, u).
Boucle de rétroaction Cyberwheel : L'action primitive a_t est injectée dans l'environnement simulant le réseau face à l'agent rouge scripté, générant en retour la transition d'état et la récompense scalaire r_t.
Les actions primitives u ∈ U = {DEPLOY DECOY, ISOLATE HOST, NOTHING} associées aux cibles τ sont définies comme suit :
DEPLOY DECOY : Déploie un leurre interactif au niveau du sous-réseau désigné pour intercepter ou dériver les tentatives de reconnaissance et de déplacement latéral.
ISOLATE HOST : Isole un hôte spécifique du réseau au niveau IP pour bloquer la progression d'une infection active.
NOTHING : Maintient l'état courant du réseau sans engager de ressources.
Configurations hiérarchiques comparées
L'architecture contrôleur-agnostique permet d'évaluer trois configurations sous des interfaces d'observation, d'action et de récompense strictly identiquement calibrées :
RL+RL : Baseline hiérarchique intégrale où le planificateur et l'exécuteur sont deux politiques PPO (Proximal Policy Optimization) réentraînées de manière ad hoc pour chaque échelle de réseau.
LLM+RL : Planificateur stratégique géré par un LLM frozen opérant en zero-shot, couplé à un exécuteur tactique PPO préalablement entraîné sur l'environnement.
LLM+LLM : Architecture entièrement basée sur des LLM frozen, où la planification stratégique et l'exécution tactique sont toutes deux confiées à un modèle de langage sans mise à jour de ses poids.
Fonction de récompense commune
Tous les contrôleurs sont évalués selon une fonction de récompense additive unique r_t mesurant le rendement opérationnel :
r_t = - ∑{c ∈ C_t} σ(c) + ∑{b ∈ B_t} β(b) - κ(a_t) - φ(a_t, s_t)
La paramétrisation numérique exacte de cette fonction se détaille ainsi :
Pénalité de progression de l'attaquant (σ) : Appliquée à chaque sous-action réussie c ∈ C_t par l'attaquant, pondérée par sa sévérité sur la chaîne d'attaque : σ = {1, 2, 5, 10, 20, 50} respectivement pour pingsweep, portscan, discovery, lateral movement, privilege escalation et impact.
Bénéfices défensifs (β) : Accordés pour chaque résultat productif b ∈ B_t, incluant un bonus de +15 pour la dérivation de l'attaquant vers un leurre ou le blocage d'un déplacement latéral, +10 pour la détection ou la capture explicite de l'agent rouge, et +25 pour la préservation réussie d'un actif critique.
Coûts directs d'action (κ) : ISOLATE HOST engendre un coût immédiat de -1 et un coût récurrent de -0,1 par pas d'environnement. DEPLOY DECOY n'impose aucun coût immédiat (0), mais induit un coût récurrent de -0,1 par pas, plafonné à un cumul maximal de -1,5. NOTHING présente un coût nul.
Disruption collatérale (φ) : Une pénalité de -10 est appliquée pour toute action d'isolation non justifiée frappant un hôte sain non compromis.
3. Protocole expérimental et cadre d'évaluation (Cyberwheel)
L'évaluation empirique est conduite au sein du cadre de simulation Cyberwheel, développé par le Laboratoire National d'Oak Ridge (ORNL). Cet environnement modélise la topologie logique des réseaux d'entreprise sous forme de graphes d'hôtes interconnectés par des routeurs, commutateurs et pare-feux.
Échelle des réseaux
Le transfert d'échelle est évalué sur trois topologies représentant une expansion d'un facteur 67 :
Petit réseau : 15 hôtes répartis en sous-réseaux restreints.
Moyen réseau : 100 hôtes.
Grand réseau : 1 010 hôtes interconnectés.
Modèle de menace
L'attaquant rouge est un agent automatisé scripté exécutant des séquences de test Atomic Red Team alignées sur la matrice MITRE ATT&CK. Son objectif prioritaire est d'atteindre un serveur critique pour déclencher une indisponibilité de service (impact). À partir d'un point d'accès initial aléatoire, l'attaquant déroule la séquence linéaire suivante : pingsweep (σ=1) → portscan (σ=2) → discovery (σ=5) → lateral movement (σ=10) → privilege escalation (σ=20) → impact (σ=50).
Infrastructure et exécution des LLM
Toutes les inférences de modèles de langage sont exécutées localement via le serveur d'inférence Ollama sur une plateforme matérielle dédiée composée d'un unique GPU NVIDIA H100 (80 Go VRAM). Afin de maximiser l'efficience mémoire sans dégrader la capacité de raisonnement, les modèles sont chargés en quantification Q4_K_M. La génération des décisions s'effectue selon un décodage déterministe à basse température (argmax).
Chaque état d'observation est transmis au LLM sous forme de prompt textuel structuré, et le modèle doit retourner une décision au format JSON strict. Sur l'ensemble des campagnes expérimentales, un taux de parsing valide de 100 % a été obtenu : aucune règle de secours heuristique (no heuristic fallback) n'a dû être sollicitée pour corriger un format de sortie invalide.
Modèles LLM évalués
L'étude analyse six modèles dont la taille varie de 3 à 70 milliards de paramètres, combinant architectures généralistes et modèles spécialisés en cybersécurité.
| Nom du Modèle | Taille (Paramètres) | Spécialisation |
| Llama-3.2-3B | 3B | Généraliste |
| Qwen3-8B | 8B | Généraliste |
| Foundation-Sec-8B | 8B | Spécialisé (Cybersécurité) |
| Qwen3-32B | 32B | Généraliste |
| Trendyol-Cybersecurity-70B | 70B | Spécialisé (Cybersécurité) |
| Llama-3.3-70B | 70B | Généraliste |
Remarque : Pour les modèles Qwen3-8B et Qwen3-32B, le mode de raisonnement explicite (thinking mode) a été activé au niveau du planificateur stratégique.
4. Analyse comparative des performances et transfert d'échelle
L'évaluation statistique repose sur 20 épisodes indépendants de 100 étapes d'environnement par configuration, sous un grain d'aléatoire (seed) globalement fixé pour garantir une parfaite répétabilité des attaques. Les métriques normalisées enregistrées sont :
Taux de compromission (C %) : Fréquence normalisée des déplacements latéraux réussis par l'attaquant.
Taux d'impact (I %) : Fréquence de réussite de l'action finale de destruction ou déni de service (critère de sécurité primaire).
Taux de défense (D %) : Proportion d'étapes où l'action de l'attaquant a échoué ou a été dérivée vers un leurre.
Tableau récapitulatif des performances d'échelle
| Échelle du Réseau | Configuration / Modèle | LLM+RL: C (%) | LLM+RL: I (%) | LLM+RL: D (%) | LLM+LLM: C (%) | LLM+LLM: I (%) | LLM+LLM: D (%) |
| Petit (15 hôtes) | Baseline RL+RL | C = 5,32 | I = 1,22 | D = 75,52 | - | - | - |
| Foundation-Sec-8B† | 4,35 | 0,25 | 78,00 | 6,35 | 0,15 | 72,30 | |
| Qwen3-32B | 4,80 | 3,50 | 73,60 | 2,10 | 0,60 | 90,70 | |
| Trendyol-70B† | 6,90 | 13,65 | 56,10 | 1,30 | 0,05 | 92,45 | |
| Llama-3.3-70B | 7,15 | 16,45 | 53,10 | 1,15 | 0,10 | 90,90 | |
| Moyen (100 hôtes) | Baseline RL+RL | C = 14,88 | I = 5,10 | D = 68,38 | - | - | - |
| Foundation-Sec-8B† | 11,35 | 2,70 | 47,05 | 10,20 | 3,20 | 50,60 | |
| Qwen3-32B | 10,45 | 2,25 | 48,45 | 2,25 | 0,25 | 84,70 | |
| Trendyol-70B† | 9,20 | 2,40 | 51,55 | 8,70 | 2,80 | 57,80 | |
| Llama-3.3-70B | 11,95 | 3,20 | 41,50 | 1,40 | 0,05 | 87,00 | |
| Grand (1 010 hôtes) | Baseline RL+RL | C = 17,95 | I = 15,20 | D = 50,01 | - | - | - |
| Foundation-Sec-8B† | 10,75 | 8,40 | 32,30 | 1,85 | 0,85 | 82,30 | |
| Qwen3-32B | 11,75 | 9,25 | 25,00 | 1,15 | 0,10 | 83,10 | |
| Trendyol-70B† | 13,05 | 10,85 | 20,05 | 14,45 | 11,60 | 12,95 | |
| Llama-3.3-70B | 11,75 | 9,25 | 25,00 | 1,00 | 0,00 | 87,95 |
(† indique un modèle spécialisé en cybersécurité)
Limites structurelles de la planification LLM seule (LLM+RL)
L'analyse des résultats démontre que remplacer le seul planificateur par un LLM tout en maintenant un exécuteur RL PPO produit des gains extrêmement marginaux lors de la montée en échelle. Sur le grand réseau (1 010 hôtes), la configuration LLM+RL subit une dégradation sévère, affichant des taux de compromission C % élevés (entre 10,75 % et 13,05 %) et des taux d'impact I % inacceptables (entre 8,40 % et 10,85 %).
L'explication causale de cet échec réside dans la nature de l'exécuteur PPO. Entraîné sur des sous-ensembles topologiques restreints, l'exécuteur RL apprend une politique liée aux identifiants stricts et aux indexations locales des hôtes de son environnement d'entraînement. Lorsque le planificateur LLM sélectionne correctement le sous-réseau pertinent (g_t), l'exécuteur PPO sur-appris se montre incapable de résoudre les actions primitives adéquates au niveau des hôtes individuels dans un espace d'états étendu ou inconnu. La couche tactique RL constitue ainsi le véritable goulot d'étranglement structurel au transfert d'échelle.
Efficacité de l'extension tactique intégrale (LLM+LLM)
Lorsque le contrôle par LLM est étendu simultanément à la planification et à l'exécution tactique (LLM+LLM), la rupture de performance est nette :
Llama-3.3-70B démontre une invariance d'échelle remarquable. Sur les trois topologies (15, 100 et 1 010 hôtes), son taux de compromission C % reste verrouillé à 1,15 %, 1,40 % et 1,00 %, tandis que le taux d'impact I % est maintenu à un niveau quasi nul (0,10 %, 0,05 % et 0,00 %). Ce modèle conserve sa capacité de neutralisation à un niveau optimal avec des poids rigoureusement gelés, alors que la baseline RL+RL s'effondre à I % = 15,20 % sur le grand réseau malgré son réentraînement spécifique.
Qwen3-32B affiche un comportement similaire, maintenant C % ≤ 2,25 % et I % ≤ 0,60 % sur l'ensemble des échelles.
Spécialisation sectorielle versus capacité générale de raisonnement
Les expérimentations mettent en lumière des arbitrages critiques entre la taille des modèles et leur spécialisation métier :
Sous-performance des architectures légères : Le modèle Llama-3.2-3B échoue à stabiliser la défense, atteignant un taux de compromission C % de 17,00 % et un taux d'impact I % de 14,10 % sur le grand réseau en LLM+LLM. Ses capacités de raisonnement contextuel réduites ne permettent pas de gérer la complexité combinatoire des grands graphes.
Effondrement de Trendyol-Cybersecurity-70B : Bien qu'efficace sur le petit réseau (C % = 1,30 % en LLM+LLM), ce modèle spécialisé voit ses performances se dégrader brutalement sur le grand réseau, atteignant C % = 14,45 % et I % = 11,60 %. Cette dégradation suggère que le fine-tuning spécialisé sur des corpus cyber agressifs peut altérer les facultés de raisonnement logique généralistes nécessaires à la résolution de problèmes décisionnels complexes à grande échelle.
Efficacité ciblée de Foundation-Sec-8B : À échelle intermédiaire (8B), la spécialisation métier s'avère bénéfique. Foundation-Sec-8B surpasse le modèle généraliste Qwen3-8B sur le grand réseau en configuration LLM+LLM, réduisant le taux de compromission C % à 1,85 % (contre 4,60 % pour Qwen3-8B) et l'impact I % à 0,85 % (contre 2,95 %).
5. Synthèse des constats techniques pour l'architecture des cyberdéfenses
Invariance d'échelle sans réentraînement : Les modèles de langage généralistes de grande taille (70B) dotés de capacités de raisonnement approfondies conservent une efficacité défensive maximale (impact quasi nul) sur des variations de taille de réseau allant jusqu'à un facteur 67, en conservant leurs poids gelés (frozen) et sans nécessiter le moindre ajustement paramétrique.
Rôle critique de la couche tactique : Introduire un LLM au seul niveau de la planification stratégique (LLM+RL) est insuffisant pour garantir le passage à l'échelle, car l'exécuteur RL bas niveau reste limité par le sur-couplage à sa topologie d'entraînement. L'extension du contrôle LLM à l'exécution tactique (LLM+LLM) est la condition nécessaire pour débloquer la robustesse aux changements d'échelle.
Absence de garantie par la seule spécialisation sectorielle : L'ajustement fin (fine-tuning) d'un modèle dans le domaine de la cybersécurité ne pallie pas un manque de capacité générale de raisonnement. Si la spécialisation apporte un gain mesurable à taille modérée (8B), elle peut détériorer le transfert d'échelle sur de très grands modèles si elle altère leurs facultés de raisonnement logique général.