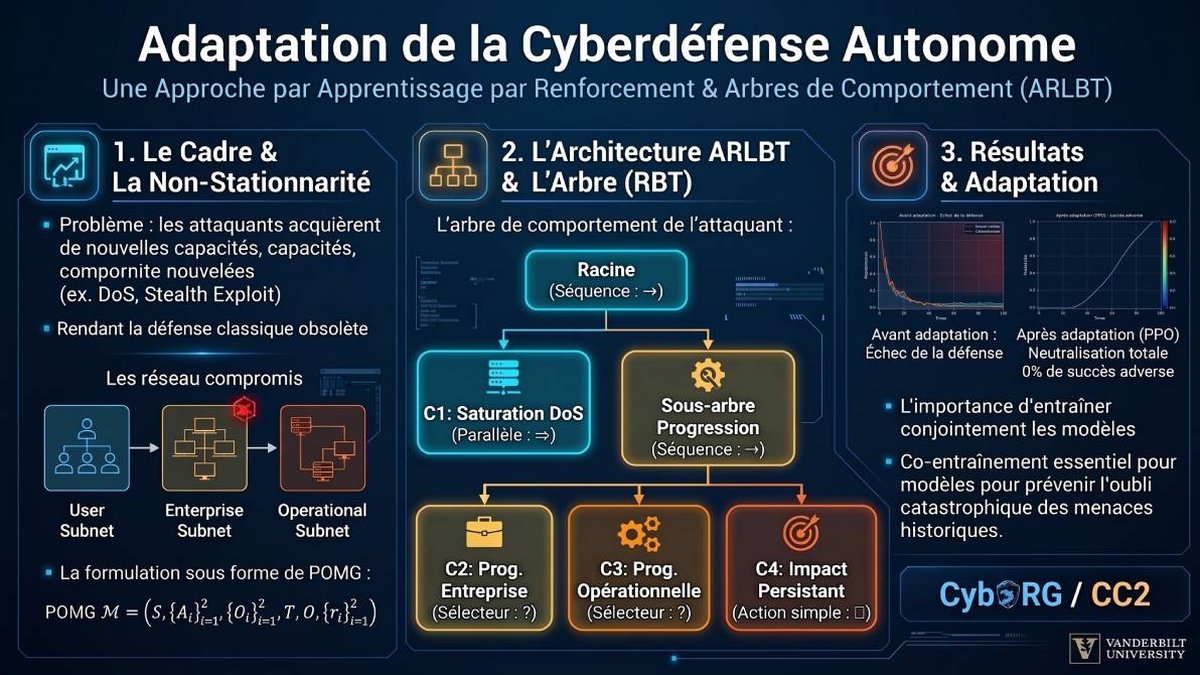
Adaptation de la Cyberdéfense Autonome face à l'Évolution des Capacités d'Attaque
Une Approche par Apprentissage par Renforcement et Arbres de Comportement
Source : Potteiger, N., Samaddar, A., & Koutsoukos, X. (2026). Adaptive cyber-defense for evolving attacker capabilities using reinforcement learning and behavior trees. arXiv
Sommaire : Face à la non-stationnarité des cybermenaces, les politiques fixes d'apprentissage par renforcement (RL) subissent un effondrement de leurs performances dès qu'un attaquant acquiert de nouvelles capacités (DoS, exploitation furtive).
L'architecture neurosymbolique ARLBT résout ce défi en combinant des Arbres de Comportement de Récompense (RBT) et un agent GNN Actor-Critic. Cette approche structure les objectifs d'intrusion tout en optimisant l'exploration de l'adversaire. Face aux défenseurs de référence (KEEP, CardiffUni), ARLBT génère des attaques inédites avec jusqu'à 73 % de succès. Enfin, le réentraînement adversarial de la défense rétablit une neutralisation totale (0 % de succès adverse) sans oubli catastrophique des menaces historiques.
1. Cadre Problématique : La Non-Stationnarité dans la Cyberdéfense Autonome
L'automatisation de la cyberdéfense d'entreprise via l'apprentissage par renforcement (RL) constitue un axe clé pour l'implémentation de cadres opérationnels modernes de gestion continue de l'exposition aux menaces (Continuous Threat Exposure Management - CTEM) et de simulation automatisée d'attaques et de brèches (Breach & Attack Simulation - BAS). Les agents de défense autonomes réduisent significativement la charge cognitive des équipes SOC en assurant une surveillance continue des réseaux d'entreprise et en exécutant des réponses aux intrusions en temps réel. Toutefois, l'environnement opérationnel de la cyberdéfense est fondamentalement non stationnaire. L'apparition de nouvelles capacités chez l'attaquant - sous la forme de vecteurs d'exploitation inédits, de techniques d'évasion avancées ou de mécanismes de déni de service ciblés - génère un désalignement critique entre l'environnement dans lequel la politique de défense a été initialement entraînée et le paysage réel de menaces rencontré lors du déploiement.
Lorsqu'un attaquant acquiert de nouvelles capacités d'action, une politique de défense entraînée exclusivement face à un ensemble statique d'attaques subit un effondrement de ses performances. Les cadres traditionnels de simulation d'attaques s'appuient souvent sur des graphes d'attaque déterministes (ex. MITRE ATT&CK) qui échouent à capturer la nature exploratoire des menaces avancées. À l'inverse, l'apprentissage par renforcement classique peine à naviguer dans des espaces d'actions en constante expansion sans signal de guidage explicite.
Dans la littérature récente, les tentatives d'adaptation des agents de défense autonomes s'articulent autour de trois axes principaux :
- Basculement dynamique de politiques fixes : Utilisation d'arbres de comportement (BT) déterministes pour basculer en temps réel entre plusieurs politiques de défense spécialisées en réponse à des déviations comportementales observées chez l'adversaire.
- Généralisation topologique : Utilisation de l'apprentissage par curriculum (ex. environnement FARLAND) ou d'architectures de réseaux de neurones graphiques (GNN) inductifs permettant de maintenir l'efficacité de la défense face à des modifications d'échelle ou de connectivité topologique du réseau.
- Apprentissage par renforcement adversarial (ARL) classique : Entraînement conjoint et co-évolutif d'agents d'attaque et de défense au sein de jeux de simulation stochastiques afin d'accroître la robustesse globale des politiques de défense par auto-confrontation.
Limite commune : Toutes ces approches reposent sur l'hypothèse restrictive que l'espace d'actions et de capacités opérationnelles de l'attaquant demeure strictement stationnaire. Elles ne permettent ni de modéliser l'émergence d'adversaires exploitant de nouvelles primitives d'attaque, ni d'adapter subséquemment les politiques de défense face aux stratégies complexes découlant de l'intégration de ces nouvelles capacités. Les approches neurosymboliques, combinant la structuration hiérarchique des arbres de comportement (RBT) et la puissance exploratoire du RL, permettent précisément de faire la jonction entre la rigidité des graphes d'attaque traditionnels et la volatilité des environnements stochastiques.
2. Modélisation de l'Environnement et Nouvelles Actions d'Attaque (CybORG / CC2)
Formulation Mathématique du Système
L'environnement réseau est modélisé sous la forme d'un Jeu de Markov Partiellement Observable (POMG) à n=2 agents (le défenseur i=1 et l'attaquant i=2), défini par le tuple :
𝓜 = (S, {Aᵢ}ᵢ₌₁², {Oᵢ}ᵢ₌₁², T, O, {rᵢ}ᵢ₌₁²)
Où S représente l'espace d'états globaux, Aᵢ l'espace d'actions de l'agent i, et Oᵢ son espace d'observations. L'action conjointe au pas de temps t est notée aᵗ := (a₁ᵗ, a₂ᵗ). La fonction de transition stochastique T(sᵗ⁺¹ | sᵗ, aᵗ) détermine le passage à l'état suivant, tandis que la fonction d'observation O(oᵗ | sᵗ) génère l'observation conjointe oᵗ := (o₁ᵗ, o₂ᵗ).
L'état global du réseau s ∈ S est représenté sous la forme d'un graphe attribué G = (V, E), où les sommets V modélisent les hôtes, serveurs, routeurs de sous-réseau, processus et fichiers, et les arêtes E = {(u, v) | u, v ∈ V} représentent les relations de propriété, de parenté et de connectivité réseau. Les caractéristiques individuelles des sommets sont définies par la fonction f: V → ℝᵈ, regroupées dans la matrice d'attributs X.
Chaque agent dispose d'une vue partielle oᵢᵗ = (Vᵢᵗ, Eᵢᵗ, Xᵢᵗ) de l'état global sᵗ ∈ S. Le défenseur perçoit d'emblée la topologie réseau globale V₁ᵗ, tandis que l'attaquant initialise son observation o₂⁰ sur le seul nœud initialement compromis et doit étendre progressivement ses sous-ensembles observables V₂ᵗ ⊆ V, E₂ᵗ ⊆ E et X₂ᵗ via ses actions d'exploration. En raison de la dépendance vis-à-vis des historiques d'observations et d'actions hᵢᵗ = (oᵢ¹, aᵢ¹, …, oᵢᵗ), les fonctions de récompense rᵢ(hᵢᵗ) sont non markoviennes pour capturer les dépendances temporelles d'une intrusion multi-étapes.
Topologie du Réseau (CC2)
L'environnement de simulation s'appuie sur le scénario CAGE Challenge Scenario 2 (CC2) développé dans la plateforme CybORG. La topologie est divisée en trois sous-réseaux distincts :
- Sous-réseau Utilisateur (User Subnet) : Contient 5 hôtes non critiques sur l'un desquels l'attaquant commence son intrusion.
- Sous-réseau Entreprise (Enterprise Subnet) : Contient 3 serveurs fournissant des services aux utilisateurs ainsi qu'un hôte dédié à la plateforme d'administration du défenseur.
- Sous-réseau Opérationnel (Operational Subnet) : Contient 3 hôtes opérationnels et un serveur opérationnel critique exécutant un service industriel stratégique.
Objectifs opérationnels : L'objectif prioritaire de l'attaquant est de s'infiltrer latéralement jusqu'au serveur opérationnel critique pour y exécuter de façon soutenue l'action Impact. L'objectif du défenseur est de préserver l'intégrité du service critique en neutralisant l'attaquant, tout en minimisant l'impact sur la qualité de service (QoS) découlant de ses propres actions de restauration système.
Comparaison des Capacités d'Action
Catégorie d'action | Scénario Original (CC2) | Extension / Nouvelles Actions | |
Actions du Défenseur (A_1) |
| Identique au scénario de base. | |
Actions d'Attaque de Base (A_0^2) |
| Maintien de l'ensemble de base A_0^2 au sein du nouvel espace d'actions A_1^2 = A_0^2 \cup A_2^+. | |
Nouvelles Actions d'Attaque (A_2^+) | Aucune (espace d'actions d'attaque immobile). |
|
3. L'Architecture ARLBT : Reinforcement Learning & Reward Behavior Trees
L'extension de l'espace d'actions de l'attaquant (A_1^2) accroît la dimensionnalité combinatoire de l'espace d'états-actions de l'adversaire dans le POMG. Cette complexité génère un problème sévère de signal de récompense sparse (sparse reward) sur de longs horizons temporels. La méthode ARLBT (Adversarial Reinforcement Learning with Behavior Trees) résout la malédiction de la dimensionnalité en combinant la modularité des Arbres de Comportement de Récompense (RBT) avec l'efficacité d'échantillonnage de l'optimisation par politique restreinte.
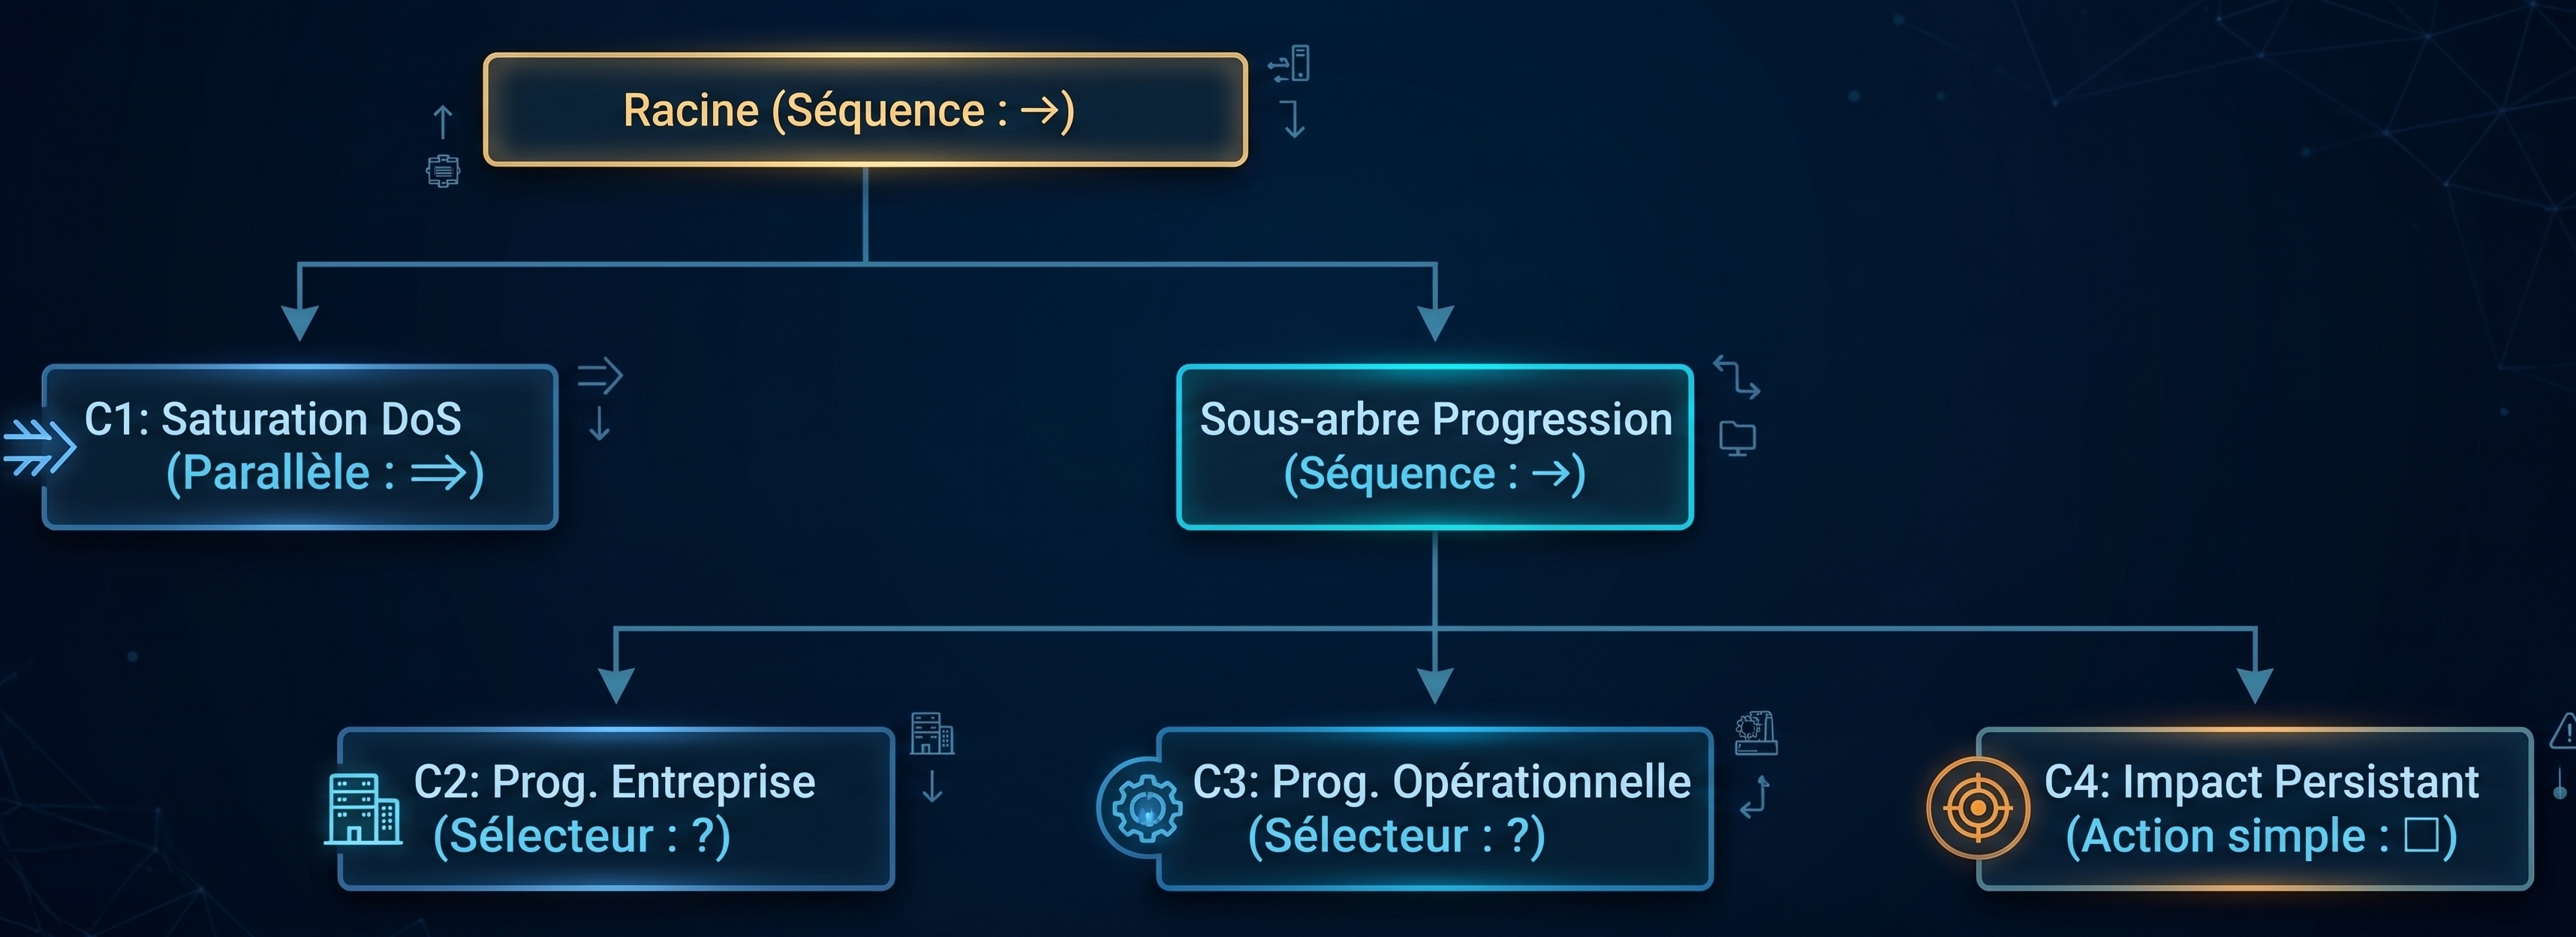
L'abstraction fournie par le RBT permet d'éviter l'explosion combinatoire en décomposant le problème global en sous-objectifs hiérarchiques. En particulier, l'exécution parallèle (\Rightarrow) au sein du sous-arbre C_1 permet l'accumulation simultanée de récompenses liées au déni de service sur plusieurs nœuds distribués sans requérir une modélisation explicite du produit cartésien de tous les états de saturation possibles.
Mécanisme des Reward Behavior Trees (RBT)
Au sein d'un RBT τᴿ, chaque nœud feuille est formalisé sous la forme d'une Machine de Récompense (Reward Machine RM) simple, représentée par le tuple ⟨U, u₀, δᵤ, δᵣ⟩. Les RM partagent l'ensemble d'états internes U = {Running, Success, Failure}, calqué de manière exacte sur les statuts de retour d'un arbre de comportement traditionnel.Soit P l'ensemble des propositions logiques évaluées sur le réseau par une fonction d'étiquetage ℓ₂(o₂ᵗ⁺¹, a₂ᵗ) → σᵗ⁺¹ ∈ 2ᴾ. Les propositions atomiques ρᵢ associées aux nœuds vᵢ ∈ V₂ᵗ découverts par l'attaquant sont définies formellement comme suit :
- ρₐ(vᵢ) : le nœud vᵢ appartient au sous-réseau Utilisateur.
- ρᵦ(vᵢ) : le nœud vᵢ est un serveur du sous-réseau Entreprise.
- ρ꜀(vᵢ) : le nœud vᵢ est le serveur opérationnel critique.
- ρᏧ(vᵢ) : un accès initial (session) a été obtenu sur vᵢ (nœud exploité).
- ρₑ(vᵢ) : des privilèges d'administration ont été obtenus sur vᵢ.
- ρ_f(vᵢ) : l'action EnableDoS est active sur le nœud vᵢ.
- ρ_g(vᵢ) : l'action Impact a été exécutée avec succès sur vᵢ.
À chaque pas de temps t+1, la transition d'état de la RM pour une feuille b appartenant à l'ensemble des feuilles exécutées εₜ⁺¹ suit la fonction de transition δᵤᵇ :uᵗ⁺¹(b) = δᵤᵇ(uᵗ(b), σᵗ⁺¹) si b ∈ εₜ⁺¹, sinon uᵗ(b)La fonction de récompense globale transmise à l'attaquant r₂ᵗ⁺¹ = R_τᴿ(λᵗ⁺¹) est calculée en faisant la somme algébrique des récompenses scalaires issues de la fonction δᵣᵇ pour chaque feuille exécutée :
R_τᴿ(λᵗ⁺¹) = ∑_{b ∈ εₜ⁺¹} δᵣᵇ(uᵗ(b), σᵗ⁺¹)
Conditionnement de Politique par Ensembles DisjointsPour maximiser l'efficacité d'échantillonnage, l'RBT est structuré en m=4 ensembles de comportements disjoints C = {C₁, C₂, C₃, C₄} ⊆ 2ᴮ. Une fonction de sélection ϕ_τᴿ(λᵗ) → Cₜ associe l'historique d'étiquetage λᵗ = ⟨σ⁰, …, σᵗ⟩ à l'ensemble Cₜ correspondant à la dernière feuille exécutée bₑ ∈ εₜ. La politique d'attaque est alors explicitement conditionnée sous la forme π₂(· | o₂ᵗ, Cₜ, θ₂), guidant la distribution d'actions à travers quatre phases stratégiques :
- C_1 (Saturation par DoS Parallèle) : Sous-arbre sous un nœud de contrôle Parallèle ⇒ surveillant les N=13 hôtes et serveurs du réseau. Il délivre un signal de récompense à chaque exécution de
EnableDoSet renvoie le statutSuccessdès qu'un seuil k=3 nœuds sous déni de service est atteint (soit ~23% de l'infrastructure), créant un canal de diversion massif. - C_2 (Progression Entreprise) : Structure à Sélecteur/Fallback ? et Séquence ⇒ validant l'exploration et l'exploitation furtive (
StealthExploitRemoteService) des serveurs du sous-réseau Entreprise à partir du point d'ancrage utilisateur. - C_3 (Progression Opérationnelle) : Structure supervisant le déplacement latéral, l'élévation de privilèges et la compromission directe du serveur opérationnel critique.
- C_4 (Impact Persistant) : Évaluation et récompense continue de l'exécution réussie de l'action
Impactsur le service critique.
Architecture Neuronale du Réseau d'Attaque (GNN Actor-Critic)
L'agent d'attaque s'appuie sur une architecture Actor-Critic à base de réseaux de neurones graphiques (GNN) et de couches d'attention globale. L'observation de l'attaquant o₂ᵗ est traitée par 2 couches de réseaux convolutifs pour graphes (Graph Convolutional Network - GCN). Des couches d'attention globale sont intercalées entre les couches GCN afin d'extraire un vecteur de contexte global représentant l'état du réseau.
Ce vecteur de contexte global est concaténé aux représentations vectorielles (embeddings) des nœuds produites par les couches GCN. Toutes les couches cachées utilisent une dimension d=64.
- Critique : Reçoit le vecteur global et les embeddings de nœuds, puis les passe à travers une couche entièrement connectée pour estimer la valeur d'état scalarisée V(s).
- Acteur : Reçoit ces représentations et calcule les logit d'actions sur l'ensemble des nœuds du réseau, sous l'hypothèse d'une borne supérieure connue du nombre de nœuds (N=13).
- Masquage d'actions (Action Masking) : Les logits d'action correspondant aux nœuds non encore découverts (v_i \notin V_2^t) sont soumis à un masquage strict. Cela interdit à l'acteur de sélectionner des actions ciblées sur des ressources inobservables, garantissant ainsi le respect de la contrainte d'observabilité partielle du POMG.
Algorithme d'Entraînement ARLBT (Basé sur PPO)
Le processus d'entraînement conjoint et d'adaptation s'exécute selon la procédure opérationnelle séquentielle suivante :
- Initialisation des paramètres et des structures:
- Charger les paramètres de la politique de défense pré-entraînée \theta_1.
- Initialiser aléatoirement les paramètres θ₂ du réseau Actor-Critic de l'attaquant.
- Définir l'environnement POMG 𝓜, l'RBT d'attaque τᴿ avec N=13, k=3, et la fonction d'étiquetage ℓ₂.
- Collecte de trajectoires et sélection contextuelle:
- Pour chaque pas de temps t ∈ [0, T-1] de l'épisode e ∈ [1, E] : a. Identifier l'ensemble de comportements actif : Cₜ ← ϕ_τᴿ(λᵗ). b. Échantillonner l'action du défenseur : a₁ᵗ ~ π₁(· | o₁ᵗ, θ₁). c. Échantillonner l'action de l'attaquant conditionnée par l'RBT : a₂ᵗ ~ π₂(· | o₂ᵗ, Cₜ, θ₂). d. Exécuter l'action conjointe aᵗ = (a₁ᵗ, a₂ᵗ) dans 𝓜 et observer sᵗ⁺¹, o₁ᵗ⁺¹, o₂ᵗ⁺¹.
- Mise à jour des historiques et calcul des récompenses:
- Mettre à jour l'historique d'étiquetage : λᵗ⁺¹ ← (λᵗ, ℓ₂(o₂ᵗ⁺¹, a₂ᵗ)).
- Mettre à jour l'historique global : hₛᵗ⁺¹ ← (hₛᵗ, aᵗ, sᵗ⁺¹).
- Obtenir la récompense du défenseur depuis l'état global : r₁ᵗ⁺¹ ← r₁(hₛᵗ⁺¹).
- Calculer la récompense façonnée de l'attaquant via l'RBT : r₂ᵗ⁺¹ ← R_τᴿ(λᵗ⁺¹).
- Accumuler les transitions (o₁ᵗ, a₁ᵗ, r₁ᵗ⁺¹, o₁ᵗ⁺¹) dans D₁ et (o₂ᵗ, Cₜ, a₂ᵗ, r₂ᵗ⁺¹, o₂ᵗ⁺¹) dans D₂.
- Optimisation par PPO (Proximal Policy Optimization):
- Si l'optimisation s'applique à l'attaquant (i=attaquant), mettre à jour θ₂ en maximisant l'objectif écrêté de PPO sur le tampon D₂ :
θ₂ ← θ₂ + α_actor ∇_θ₂ Lᴾᴾᴼ(θ₂; D₂)
- Si l'optimisation s'applique au défenseur (i=défenseur), mettre à jour θ₁ sur le tampon D₁ en échantillonnant conjointement des trajectoires générées par l'attaquant ARLBT et par les attaquants déterministes historiques (
BLine,Meander).
4. Évaluation Expérimentale des Performances d'Attaque
L'évaluation expérimentale vise à mesurer la capacité d'ARLBT à générer des politiques d'attaque offensives optimisées face à deux politiques de défense de référence :
CardiffUni: Agent lauréat de la compétition CAGE Challenge Scenario 2, s'appuyant sur des politiques entraînées séparément contreBLineetMeanderavec une sélection heuristique au moment de l'exécution.KEEP: Agent d'état de l'art basé sur un réseau de neurones graphiques (GNN) à couches d'attention globale, capable de généraliser à des variations de topologie réseau.
Hyperparamètres d'Entraînement
Les paramètres de simulation sont configurés de manière stricte : la borne de nœuds est N = 13, le seuil DoS est k = 3 (requérant la saturation de 23% des nœuds dans les scénarios +DoS et +DoS,Stealth, et k=0 pour Orig et +Stealth). Chaque cycle d'évaluation s'exécute sur une durée d'épisode T = 100 pas de temps. L'entraînement est réalisé sur I = 500 itérations avec E = 25 épisodes par itération. Les taux d'apprentissage de l'acteur et du critique PPO sont fixés respectivement à 3 \times 10^{-4} et 1 \times 10^{-3}.
Taux de Succès de l'Attaquant (Attacker Success)
Le taux de succès représente la proportion moyenne de pas de temps au cours d'un épisode durant lesquels l'action Impact est maintenue active sur le serveur opérationnel critique (évalué sur 1 000 épisodes indépendants) :
Défenseur | Scénario | BLine | Meander | ARL (CC2) | ARLBT (Reward Only) | ARLBT (Full) |
CardiffUni | Orig | 0.00 | 0.00 | 0.03 | 0.65 | 0.66 |
+DoS | 0.00 | 0.00 | 0.04 | 0.58 | 0.61 | |
+Stealth | 0.00 | 0.00 | 0.07 | 0.72 | 0.72 | |
+DoS,Stealth | 0.00 | 0.00 | 0.24 | 0.73 | 0.67 | |
KEEP | Orig | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
+DoS | 0.00 | 0.00 | 0.00 | 0.42 | 0.43 | |
+Stealth | 0.00 | 0.00 | 0.14 | 0.73 | 0.71 | |
+DoS,Stealth | 0.00 | 0.00 | 0.15 | 0.60 | 0.63 |
Analyse Factuelle des Résultats
- Effondrement des attaquants statiques et de l'ARL classique : Les politiques déterministes historiques (
BLineetMeander) sont intégralement neutralisées par les défenseurs de référence, enregistrant un taux de succès de 0.00 dans l'ensemble des scénarios. L'agentARL (CC2), entraîné par renforcement classique avec la fonction de récompense d'origine de CybORG, échoue à exploiter les nouvelles capacités (succès limité entre 0.00 et 0.24) en raison de l'absence de signal de guidage sur l'avancement de l'intrusion. - Efficacité des récompenses basées sur l'RBT : L'introduction du RBT permet d'atteindre des taux de compromission élevés, montant jusqu'à 0.73 face à
CardiffUniet 0.71 face àKEEP. - Gain d'efficacité d'échantillonnage via le conditionnement contextuel : Le conditionnement direct de la politique de l'attaquant sur les ensembles de comportements disjoints (
ARLBT Full) démontre une supériorité systématique par rapport à l'utilisation du RBT comme simple fonction de récompense passive (ARLBT Reward Only). Dans le scénario le plus complexe (+DoS,Stealth) face àKEEP,ARLBT Fullsurpasse l'ablationReward Onlyavec une amélioration relative du taux de succès final de 14,5% (0.63 contre 0.60), confirmant la valeur opérationnelle du conditionnement contextuel.
5. Adaptation et Résilience des Politiques de Défense
Pour pallier le désalignement des défenseurs historiques, l'agent KEEP est soumis à une phase de réentraînement adversarial en réinjectant l'agent d'attaque généré par ARLBT au sein de l'environnement étendu. Afin d'éviter le surapprentissage (overfitting) contre le seul nouvel attaquant au détriment des attaques basiques, les politiques BLine, Meander et ARLBT Full sont échantillonnees conjointement pendant le réentraînement. L'agent CardiffUni est exclu de cette phase en raison de l'incompatibilité de son mécanisme de sélection d'actions basé sur des heuristiques rigides.
Métriques d'Adaptation du Défenseur KEEP
Le tableau suivant présente la récompense cumulative du défenseur et le taux de succès de l'attaquant (indiqué entre parenthèses) avant adaptation (Baseline) et après adaptation (Adapted), mesurés sur 1 000 épisodes :
Scénario | Baseline : ARLBT (Full) | Baseline : BLine | Baseline : Meander | Adapté : ARLBT (Full) | Adapté : BLine | Adapté : Meander |
Orig | -42.1 (0.00) | -14.9 (0.00) | -16.8 (0.00) | -35.9 (0.00) | -17.8 (0.00) | -21.1 (0.00) |
+DoS | -392.4 (0.43) | -14.9 (0.00) | -16.8 (0.00) | -21.3 (0.00) | -19.1 (0.00) | -21.5 (0.00) |
+Stealth | -757.5 (0.71) | -14.9 (0.00) | -16.8 (0.00) | -55.2 (0.08) | -24.9 (0.00) | -21.7 (0.00) |
+DoS,Stealth | -894.1 (0.63) | -14.9 (0.00) | -16.8 (0.00) | -39.7 (0.00) | -21.2 (0.00) | -18.8 (0.00) |
Analyse Mécanique de la Défense et Maintien de la Robustesse
- Rétablissement des performances de défense : Face à l'attaquant étendu dans le scénario
+DoS,Stealth, le défenseurKEEPnon adapté subissait une dégradation massive de ses performances, affichant une récompense désastreuse de -894.1 et concédant un taux de succès de 0.63. Après adaptation via ARLBT, le taux de succès de l'attaquant est ramené à 0.00 et la récompense du défenseur remonte à -39.7. - Interprétation architecturale de la résilience de
KEEP: La capacité de réadaptation spectaculaire de l'agentKEEPs'explique par sa structure sous-jacente. Utilisant un réseau de neurones graphiques inductif associé à des couches d'attention globale,KEEPparvient à corréler topologiquement des signaux faibles et dispersés - tels que des alertes DoS sur le sous-réseau utilisateur et des tentatives de latéralisation furtive (StealthExploitRemoteService) sur le sous-réseau Entreprise - pour isoler les nœuds compromis avant l'atteinte du serveur critique. - Conservation de la robustesse historique : L'échantillonnage conjoint durant la phase de réentraînement permet de prévenir l'oubli catastrophique (catastrophic forgetting). L'agent adapté conserve une neutralisation totale des attaques patrimoniales (
BLineetMeander), maintenant un taux de succès adverse de 0.00 et des pénalités de récompense très proches de la baseline d'origine (ex. de -14.9 à -21.2 pourBLinedans+DoS,Stealth).
6. Limites Techniques et Synthèse pour l'Évaluation du Risque
Apport de l'Approche Neurosymbolique au CTEM et BAS
L'architecture ARLBT valide l'apport stratégique des approches neurosymboliques (combinant Arbres de Comportement et Apprentissage par Renforcement) pour la gestion automatisée du risque cyber. En structurant formellement les étapes de progression d'une intrusion tout en laissant aux réseaux de neurones la liberté d'explorer les séquences d'actions optimales, ARLBT offre une solution robuste pour la simulation continue de menaces émergentes. Pour les architectures BAS, cette méthode constitue un moyen d'évaluer la résilience des socles de défense face à des attaquants non stationnaires sans nécessiter la réécriture complète de scripts d'attaque.
Limites Techniques Identifiées
- Dépendance à la modélisation experte des RBT : La principale contrainte opérationnelle réside dans la dépendance à la conception manuelle de l'arbre de comportement de récompense (RBT) et à la définition formelle des propositions logiques (P). Cette étape requiert une expertise métier approfondie en sécurité offensive et en analyse de menaces pour chaque extension d'action ou de topologie.
- Complexité d'échelle des propositions : La taille de l'ensemble de propositions P augmente de manière linéaire avec le nombre de nœuds découverts dans V_2^t, ce qui peut accroître la charge de calcul lors de l'évaluation des étiquetages dans des réseaux de très grande taille.
Perspectives d'Évolution
- Génération automatique d'RBT par Modèles de Langage (LLM) : Automatiser la synthèse d'arbres de comportement de récompense structurés et de leurs sous-ensembles de comportements associés en exploitant des LLM formés sur la base de connaissances MITRE ATT&CK et des rapports de cyber-renseignement sur les menaces (Threat Intelligence).
- Apprentissage continu et adaptation en ligne : Étendre l'algorithme ARLBT vers des cadres d'apprentissage continu en ligne (online continual learning), permettant aux agents de défense d'adapter dynamiquement leurs politiques d'intervention en temps réel face à l'apparition de vulnérabilités Zero-Day sans passer par une phase de réentraînement hors-ligne.