Système expert et deep learning pour la classification des sinistres cyber
Classification Automatisée des Sinistres Cyber : Apport des Données Judiciaires et du Deep Learning.
Source: Al-Qwider, W., Jaradat, R., Zaiter, I., Abutabenjeh, S., Eltoukhy, A., & Pinto, C. A. (2026). An expert system for cyber insurance incident classification using large-scale legal court records. SSRN.
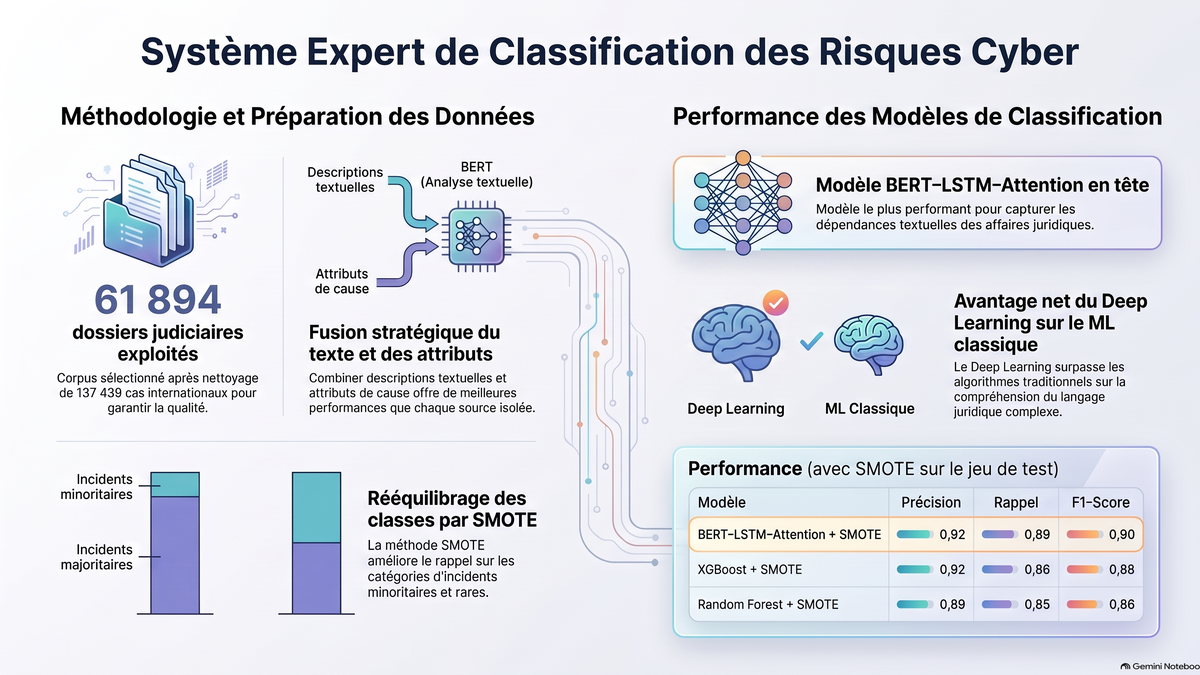
Sommaire : Face à l'incertitude et au manque d'historique en souscription cyber, cette étude propose un système expert fondé sur le deep learning pour classifier automatiquement 16 typologies d'incidents à partir des dossiers judiciaires américains (61 894 cas complets).
En associant variables structurées et narratifs textuels via une architecture BERT–LSTM–Attention couplée à la technique de rééquilibrage SMOTE, le modèle atteint un score F1 de 0,90 sur des données inédites (surpassant XGBoost et Random Forest).
Cette approche hybride surpasse la littérature NLP du domaine juridique. Elle permet d'automatiser le triage des sinistres et d'optimiser la gestion des risques, bien qu'un réétalonnage soit nécessaire hors du droit américain.
1. Introduction : La Donnée Judiciaire comme Source d'Evidence en Cyber-Assurance
L'évaluation et la souscription du risque cyber présentent une complexité singulière au sein du secteur de l'assurance. Contrairement aux branches dommage traditionnelles, le risque cyber se caractérise par une forte incertitude, un manque d'historique standardisé et une interdépendance étroite entre vulnérabilités techniques, structures organisationnelles et facteurs humains. Face à l'absence de registres de sinistres pleinement harmonisés à l'échelle de l'industrie, les comptes rendus d'audiences et dossiers judiciaires (court records) émergent comme une source d'information probante d'une richesse inédite.
Les dossiers judiciaires présentent l'intérêt d'associer un narratif textuel informel - retraçant le déroulement chronologique de l'incident, le vecteur d'attaque et l'impact opérationnel - à une qualification juridique et technique formelle des responsabilités et des préjudices. Cependant, la croissance volumétrique et l'hétérogénéité de ces pièces textuelles rendent leur analyse manuelle inenvisageable à grande échelle.
Pour répondre à cet enjeu, un système expert fondé sur l'apprentissage automatique a été conçu pour classifier automatiquement les types d'incidents cyber à partir de vastes corpus judiciaires. Il convient de préciser la définition du terme « système expert » dans ce cadre : le système n'est pas structuré autour de règles déterministes statiques de type if-then, mais constitue un système computationnel imprégné d'expertise métier (domain-informed). L'expertise du domaine y est encodée à travers la structuration des pipelines de traitement du langage naturel (NLP), l'alignement sur une taxonomie de risques propre à l'assurance cyber, et la prise en compte explicite des contraintes opérationnelles de souscription et de gestion de portefeuille. L'objectif opérationnel de ce système est de fournir une capacité d'analyse en amont pour soutenir le triage des réclamations (claims triage), l'interprétation des couvertures de police et l'agrégation des risques au sein des portefeuilles d'assurance.
2. Architecture du Système Expert et Cadre Méthodologique
2.1. Nettoyage des Données et Périmètre d'Analyse
La constitution du jeu de données d'apprentissage repose sur une réduction séquentielle et rigoureuse du corpus initial afin de garantir la qualité des signaux modélisés :
- Corpus global initial : 137 439 cas d'audiences internationales (incluant des dossiers canadiens, britanniques, etc.).
- Périmètre américain : Conservation de 117 305 dossiers originaires des États-Unis, offrant la documentation juridique la plus complète.
- Filtrage de la complétude : Exclusion ciblée de 55 411 dossiers incomplets (présentant des valeurs manquantes sur la cause immédiate, la cause secondaire ou le produit/service impliqué), conservant ainsi 61 894 cas complets U.S. L'analyse de distribution post-nettoyage confirme la préservation exacte des proportions des motifs de sinistres, garantissant l'absence de biais de sélection.
- Distribution des classes : Le jeu de données couvre 16 catégories d'incidents. Toutefois, 6 catégories prédominantes représentent 91,5 % de l'ensemble des cas, notamment "Privacy, Unauthorized Contact or Disclosure" (~50 %) et "Data, Malicious Breach" (~25 %). Les catégories restantes (divulgations involontaires, vols physiques, ingénierie sociale, interruptions réseau) apparaissent de manière nettement plus rare, reflétant le déséquilibre naturel des sinistres réels.
2.2. Représentation des Données Textuelles et Attributs Structurés
Le système expert adopte une stratégie d'apprentissage hybride combinant des attributs catégoriels structurés et la séquence contextuelle des narratifs textuels.
[Attributs Structurés] (Cause immédiate, secondaire, produit) ──> One-Hot Encoding ──┐
                                                                                   ├──> [Modèles ML / DL]
[Narratifs Textuels] (Description du sinistre) ──> TF-IDF ou Embeddings BERT ──────┘
- Pour les modèles de Machine Learning (ML) classiques (Random Forest, Support Vector Machine, XGBoost, Régression Logistique) : les variables structurées (proximate cause, secondary cause, product/service involved) sont transformées via un encodage disjonctif complet (One-Hot Encoding). Les narratifs textuels sont vectorisés à l'aide de la méthode TF-IDF (Term Frequency-Inverse Document Frequency).
- Pour les architectures de Deep Learning (DL) : le texte est traité via des plongements contextuels BERT (BERT embeddings). Pour capturer les structures linguistiques complexes, la séquence temporelle des événements et les dépendances contextuelles à long terme sur plusieurs paragraphes juridiques, les représentations BERT sont couplées à une couche récurrente LSTM et un mécanisme d'attention (BERT–LSTM–Attention).
2.3. Stratégies de Traitement du Déséquilibre de Classes
Le déséquilibre fort entre les catégories d'incidents courantes et les événements rares peut biaiser les algorithmes au détriment des sinistres minoritaires, qui portent souvent une sévérité financière élevée. Trois méthodologies de rééquilibrage ont été évaluées de manière comparative :
- Class Weighting (Pondération des pertes) : Ajuste la fonction de perte lors de l'entraînement en attribuant des pénalités financières/logiques plus fortes aux erreurs commises sur les classes minoritaires.
- SMOTE (Synthetic Minority Over-sampling Technique) : Génère des échantillons synthétiques pour les classes sous-représentées dans l'espace des descripteurs, élargissant ainsi les frontières de décision.
- Down-sampling (Sous-échantillonnage) : Réduit aléatoirement le volume des classes majoritaires pour égaliser les effectifs, au risque de supprimer de l'information utile.
3. Résultats Expérimentaux et Performances Comparatives
3.1. Évaluation en Validation Croisée
L'évaluation de la stabilité des modèles a été réalisée par validation croisée stratifiée à K-blocs. Le tableau suivant synthétise les scores F1 moyens obtenus selon les architectures et les techniques d'équilibrage appliquées :
Modèle | Class Weighting | SMOTE | Down-sampling |
Random Forest | 0.897 | 0.903 | 0.865 |
Logistic Regression | 0.890 | 0.921 | 0.804 |
SVM (Kernel Linéaire) | 0.900 | 0.921 | 0.854 |
XGBoost | 0.916 | 0.930 | 0.873 |
Deep Neural Network (DNN) | 0.924 | 0.945 | 0.877 |
BERT–LSTM–Attention | 0.931 | 0.952 | 0.883 |
Les résultats démontrent que la méthode SMOTE surpasse systématiquement les autres approches. En créant des représentations synthétiques dans l'espace des caractéristiques, SMOTE enrichit le signal d'entraînement pour les classes minoritaires sans rejeter de données majoritaires (contrairement au Down-sampling) et sans se limiter à modifier le gradient de perte (comme le Class Weighting). Les réseaux profonds, et particulièrement l'architecture BERT–LSTM–Attention, tirent le meilleur parti de cet enrichissement.
3.2. Phase d'Optimisation des Hyperparamètres (Approche Bayésienne)
Afin de maximiser la séparabilité des classes avant l'évaluation finale, une phase d'optimisation bayésienne des hyperparamètres a été conduite sur les modèles présélectionnés. Cette étape affine les paramètres de complexité, les taux d'apprentissage et la régularisation.
Modèle | Méthode d'Équilibrage | Précision | Rappel | F1-score | |||
BERT–LSTM–Attention | SMOTE | 0.983 | 0.982 | 0.982 | |||
BERT–LSTM–Attention | Class Weighting | 0.962 | 0.962 | 0.962 | |||
DNN | SMOTE | 0.976 | 0.975 | 0.975 | |||
DNN | Class Weighting | 0.954 | 0.954 | 0.953 | |||
XGBoost | SMOTE | 0.951 | 0.950 | 0.950 | |||
SVM (Kernel Linéaire) | SMOTE | 0.942 | 0.943 | 0.943 | |||
Random Forest | SMOTE | 0.941 | 0.940 | 0.940 |
Cette optimisation montre une quasi-parité entre précision et rappel (ex. 0.983 / 0.982 pour BERT–LSTM–Attention + SMOTE), attestant d'un calibrage fin des modèles qui ne sacrifient pas la détection des faux négatifs au profit de la précision globale.
3.3. Performance sur Données Test Inédites (Held-Out Test Set)
Les performances finales ont été mesurées sur un jeu de test strictement isolé de la phase d'entraînement et d'optimisation des hyperparamètres. La métrique F1-score est calculée selon la formule standard : F1 = 2 × (Précision × Rappel) / (Précision + Rappel).
L'application des techniques de rééquilibrage de classe a permis d'améliorer le rappel sur les catégories d'incidents rares de plus de 6 points de pourcentage dans plusieurs catégories minoritaires. La modeste variation observée entre la phase d'optimisation et le jeu de test final (de l'ordre de 0.03 à 0.05) confirme l'absence de surapprentissage (overfitting) et démontre la capacité de généralisation du système expert face à de nouveaux dossiers.
Modèle | Méthode d'Équilibrage | Précision | Rappel | F1-score | |||
|---|---|---|---|---|---|---|---|
BERT–LSTM–Attention | SMOTE | 0.983 | 0.982 | 0.982 | |||
BERT–LSTM–Attention | Class Weighting | 0.962 | 0.962 | 0.962 | |||
DNN | SMOTE | 0.976 | 0.975 | 0.975 | |||
DNN | Class Weighting | 0.954 | 0.954 | 0.953 | |||
XGBoost | SMOTE | 0.951 | 0.950 | 0.950 | |||
SVM (Kernel Linéaire) | SMOTE | 0.942 | 0.943 | 0.943 | |||
Random Forest | SMOTE | 0.941 | 0.940 | 0.940 |
3.4. Analyse Comparée avec la Littérature Spécialisée
Afin de situer ces performances, le modèle hybride BERT–LSTM–Attention (F1 = 0.90 sur 16 classes) a été confronté aux travaux récents appliquant le traitement du langage naturel (NLP) ou l'apprentissage automatique à la sécurité et au droit :
Étude | Source de Données | Taille du Corpus | Architecture Modèle | Target / Classes | Performance (F1) |
Présente Étude | Dossiers judiciaires (Texte + Structuré) | 61 894 cas | BERT–LSTM–Attention + SMOTE | 16 catégories d'incidents | Macro F1 = 0.90 |
Rani et al. (2024) | Plaintes informelles de cybercriminalité | 85 875 plaintes | HingRoBERTa | 14 catégories (texte code-mixed) | Macro F1 = 0.71 |
Limsopatham (2021) | Faits juridiques de la CEDH | 11 000 cas | Legal-BERT (MaxPool) | Multi-label (Articles CEDH) | Micro F1 = 0.70 – 0.82 |
Ameri et al. (2021) | Documentation technique d'équipements ICS | Corpus spécialisé | CyBERT (BERT fine-tuned) | Classification binaire / peu de classes | Macro F1 = 0.93 |
Ferrag et al. (2022) | Trafic réseau Edge-IIoTset (Télémetrie) | ~2 000 000 enregistrements | DNN centralisé | 14 classes + normal | F1 = 0.99 |
Ferrag et al. (2024) | Trafic réseau PCAP (Edge-IIoTset) | ~2 000 000 enregistrements | SecurityBERT + PPFLE | 14 classes | F1 par classe = 0.83 – 1.00 |
Cette comparaison met en évidence la robustesse de l'approche :
- Par rapport aux travaux de Limsopatham (2021) sur la CEDH, qui appliquent une stratégie de troncature à 512 tokens sur Legal-BERT, la combinaison BERT–LSTM–Attention permet de capturer les dépendances contextuelles sur des narratifs longs s'étendant sur plusieurs paragraphes sans perte de signal critique.
- Par rapport à Rani et al. (2024) (F1 = 0.71), l'utilisation de comptes rendus d'audiences structurés offre une terminologie plus cohérente et un signal sémantique plus riche que des plaintes informelles brutes.
- Enfin, face aux travaux sur données de télémétrie réseau (Ferrag et al.), qui opèrent sur des signaux numériques hautement réguliers, la présente méthodologie atteint un score F1 de 0.90 sur des narratifs juridiques complexes combinant argumentation sur la causalité, qualification des préjudices et détails techniques.
4. Implications Opérationnelles pour le Risk Management et la Souscription
L'intégration d'un tel système expert offre des leviers décisionnels concrets pour les directions du risque et les départements de souscription :
- Arbitrage Précision vs. Rappel selon l'usage métier :
- Un modèle privilégiant la précision (ex. XGBoost à 0.92) limite les faux positifs. En gestion de sinistres, cela évite le déclenchement d'enquêtes d'expertise forensique ou d'audits juridiques coûteux sur des dossiers mal qualifiés.
- À l'inverse, les architectures de Deep Learning, offrant un rappel supérieur (jusqu'à 0.89), garantissent la détection quasi exhaustive d'événements rares mais à fort impact financier (ex. interruptions de service majeures ou vols physiques de données), prévenant ainsi le sous-provisionnement des dossiers graves.
- Complémentarité démontrée des sources de données (Étude d'Ablation) : Les analyses d'ablation menées sur le système montrent que les modèles entraînés uniquement sur les attributs structurés atteignent un F1-score plafonné entre 0.72 et 0.81, tandis que ceux fondés sur le texte seul atteignent entre 0.78 et 0.89. La fusion des deux sources d'information est donc indispensable pour obtenir le niveau de performance maximal (0.90 sur jeu test, jusqu'à 0.982 lors de l'optimisation).
- Automatisation du Triage et Agrégation des Risques : Le système permet d'automatiser le triage initial des réclamations dès leur déclaration (claims triage), d'assurer une interprétation homogène des garanties face aux typologies d'attaques émergentes et d'améliorer la cartographie des cumuls de risques en catégorisant automatiquement des milliers de cas complexes.
Limites et Perspectives de Recherche
Bien que performant, ce cadre d'analyse présente des limites métrologiques et pratiques :
- Biais de juridiction et cadre réglementaire : Les données d'entraînement proviennent majoritairement du système judiciaire américain, caractérisé par des normes de divulgation (litigation discovery) et des lois d'obligation de notification spécifiques (ex. la Californie représente à elle seule 17 874 cas du corpus). L'application directe de ce modèle à des juridictions de droit civil (ex. l'Union Européenne sous régime RGPD) nécessite un réétalonnage du pipeline NLP pour s'adapter aux terminologies légales et aux cadres de déclaration régionaux.
- Intégration d'évidence technique directe : Le modèle s'appuie sur la qualification juridique a posteriori. L'intégration future de journaux techniques bruts (system logs, fichiers pcap) et de rapports d'expertise forensique aux côtés des comptes rendus d'audiences permettra d'enrichir la granularité de la classification au moment même où le sinistre est déclaré.