Prédire les Cyber-Attaques grâce aux LLM et à l'Analyse Géopolitique
Apport des Données Géopolitiques et des Modèles de Langage dans la Prédiction du Risque
Source: Fesenko, M., Garra, A., Harel, Y., & Sharif, M. (2026). Forecasting cybersecurity incidents using geopolitical data and large language models. arXiv.
Sommaire : La prédiction du cyber-risque repose sur deux dimensions : la faisabilité technique (mesurée par la télémétrie réseau) et la motivation des attaquants (stimulée par le contexte géopolitique et médiatique).
Si les indicateurs réseau traditionnels révèlent la vulnérabilité d'une organisation, ils négligent les catalyseurs d'attaques. Pour y remédier, un système RAG (Retrieval-Augmented Generation ou génération augmentée par recherche) exploite un LLM, LLaMA-2-7B, afin d'extraire des représentations sémantiques géopolitiques à partir de la presse et de podcasts transcrits avec un faible WER (Word Error Rate ou taux d'erreur de mots).
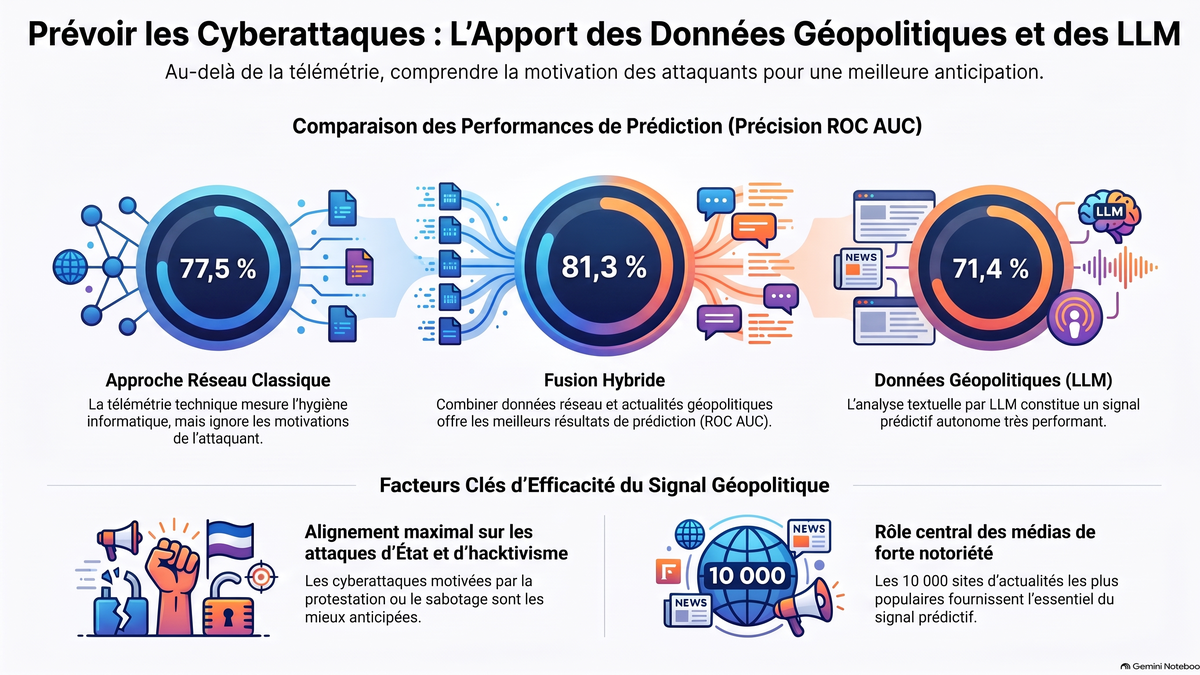
Combinant signaux géopolitiques, données GDELT (Global Database of Events, Language, and Tone) et télémétrie issue notamment d'un agrégateur BLAG (Blacklist Aggregator) via une couche de porte pondérée, l'architecture d'intégration hybride alimente un classificateur MLP (Multilayer Perceptron ou perceptron multicouche). Cette approche atteint un score ROC AUC (Receiver Operating Characteristic - Area Under Curve) de 81,3 % à horizon tactique (30 jours) et 78,6 % à horizon stratégique (1 an), surpassant les modèles fondés uniquement sur la télémétrie d'infrastructure.
Ces indicateurs avancés trouvent une application directe dans les centres d'opérations de sécurité, ou SOC (Security Operations Center), ainsi qu'en souscription d'assurance cyber.
1. Contexte et problématique de la prédiction du cyber-risque
La modélisation prédictive du cyber-risque organisationnel constitue un enjeu stratégique pour la gestion proactive de la sécurité des systèmes d'information et l'élaboration des politiques d'assurance cyber. Sur le plan opérationnel et tactique, anticiper la survenance d'un incident permet d'optimiser la gestion du risque en hiérarchisant l'application des correctifs de sécurité (patching). Pour les souscripteurs d'assurance, ces prévisions offrent une base empirique pour la tarification du risque (underwriting) et l'ajustement des plafonds de couverture.
L'objectif formel de cette démarche est d'évaluer la fonction de risque F_τ(o_org) ∈ [0, 1], définie comme la probabilité qu'une organisation donnée (org) subisse un incident de sécurité majeur au cours d'une fenêtre temporelle prospective [t, t + τ]. Deux horizons temporels sont principalement étudiés :
- Un horizon tactique à court terme ( τ = 30 jours), adapté aux opérations de remédiation et de défense active.
- Un horizon stratégique à plus long terme ( τ = 1 an), adapté au renouvellement des contrats d'assurance et aux arbitrages budgétaires.
La problématique centrale de la prédiction repose sur la dualité et la complémentarité entre deux dimensions fondamentales du risque :
- La faisabilité technique : Évaluée à partir de la surface d'attaque externe, des erreurs de configuration et de l'hygiène réseau de l'organisation.
- La motivation des attaquants : Déterminée par les tensions géopolitiques, les conflits internationaux, l'attention médiatique et les mouvements sociétaux qui désignent des cibles prioritaires aux cyber-adversaires.
Pour entraîner et valider empiriquement des modèles quantitatifs capables d'intégrer ces deux dimensions, l'étude s'appuie sur une base historique d'incidents à grande échelle. Le corpus comprend plus de 15 700 incidents majeurs (dénis de service, exfiltrations de données, rançongiciels, attaques sur infrastructures physiques) enregistrés sur une période de 12 ans au sein de la base du Center for International and Security Studies at Maryland (CISSM), complétée et corrigée par la Cyber Security Incident Database (CSIDB).
2. Limites des indicateurs techniques traditionnels
Les méthodes conventionnelles de prévision du cyber-risque s'appuient quasi exclusivement sur la télémétrie réseau et l'observation externe des infrastructures. Ces indicateurs se classent en deux catégories : les symptômes statiques de mauvaise gestion et les signaux temporels d'activité malveillante.
Le tableau ci-dessous résume la portée analytique et les limites structurelles de ces indicateurs traditionnels :
Indicateurs réseau de surface | Portée et limites analytiques | |
Symptômes statiques de mauvaise gestion :
| Portée : Mesurent le niveau d'hygiène informatique et révèlent l'absence de politiques ou de contrôles internes pour détecter et corriger les failles d'infrastructure.<br><br>Limite : Ces métriques indiquent qu'une attaque est techniquement faisable, mais ne fournissent aucune information sur la probabilité qu'un adversaire choisisse d'exploiter ces faiblesses. | |
Signaux d'activité malveillante (Séries temporelles) :
| Portée : Confirment une compromission active ou l'utilisation d'équipements à des fins malveillantes au moment de la mesure.<br><br>Limite : Capturent des événements a posteriori ou un niveau de bruit ambiant, sans détecter la constitution de nouvelles intentions d'attaque ciblant l'entité. |
Limite fondamentale : Bien que les métriques réseau fournissent un signal pertinent sur la vulnérabilité intrinsèque de la cible, elles se concentrent uniquement sur l'état passif de l'organisation. Elles négligent totalement les catalyseurs externes (crises diplomatiques, sanctions économiques, controverses publiques) qui motivent les groupes malveillants à cibler une organisation spécifique à un instant donné.
3. Architecture d'extraction des signaux géopolitiques textuels
Afin de capturer la motivation des attaquants, un pipeline d'ingestion et de traitement d'informations non structurées à grande échelle a été conçu.
Sources de données
- Articles de presse écrite : Traitement continu de l'archive
CC-NEWS(issue de Common Crawl), représentant un volume allant jusqu'à 2,5 millions d'articles mensuels sur plus d'une décennie. - Podcasts audio transcrits : Ingestion de plus de 30 000 épisodes issus de 16 sources (représentant plus de 14 000 heures d'audio). Le corpus combine des médias spécialisés en cybersécurité (Darknet Diaries, The CyberWire) et des médias d'information générale et géopolitique (The Wall Street Journal, BBC, NPR). La transcription est exécutée par le modèle open-source
Whisper-large. Ce modèle a été retenu à l'issue d'un benchmark comparatif :Whisper-largeobtient un taux d'erreur de mots (WER) de 5,61 %, un taux d'erreur d'alignement (MER) de 5,42 %, une perte d'information de mots (WIL) de 7,15 % et une préservation de l'information (WIP) de 92,85 %, surclassant nettementDeepgram(WER: 7,39 %, MER: 7,21 %) etWhisper-base(WER: 8,45 %, MER: 8,24 %).
Indexation et recherche vectorielle
Les textes en langue anglaise sont découpés en segments et transformés en représentations vectorielles denses à l'aide du modèle d'embedding Arctic-embed-m-v2.0 (supportant une fenêtre de contexte allant jusqu'à 8 192 tokens). Les vecteurs sont indexés dans une base de données FAISS partitionnée chronologiquement par mois afin de garantir le respect de la temporalité lors des requêtes.
Génération des représentations et architecture RAG
Pour une organisation donnée à un instant t, un système de génération augmentée par recherche (RAG) extrait les k=5 documents les plus pertinents pour chacune des q=6 requêtes d'extraction sur une fenêtre rétrospective de h=9 mois.
Afin d'éviter tout surajustement (overfitting) lié à l'ordre des textes présentés au modèle, les documents récupérés sont mélangés de manière aléatoire au sein de leurs groupes de requêtes respectifs avant d'être concaténés. Le texte global est ensuite encapsulé dans un prompt système configurant le modèle de langage dans la posture d'un « analyste en cybersécurité » chargé d'évaluer les tensions et les risques d'attaque.
L'ensemble est transmis au LLM LLaMA-2-7B. La représentation sémantique dense (un vecteur de 4 096 dimensions) est extraite de la couche intermédiaire 23 (sur 32). Les évaluations empiriques confirment que cette couche intermédiaire offre la meilleure capacité d'abstraction sémantique globale (ROC AUC de 0.724 à la couche 23), surpassant les couches initiales (layer 7: 0.706) et les couches finales spécialisées dans la prédiction du token suivant (layer 27: 0.719).
Requêtes d'extraction RAG et étude d'ablation
Les 6 requêtes d'extraction Q1 à Q6 ciblent les dimensions clés du risque :
- Q1 (Risque d'attaque) :"Are ORG and similar companies at risk of cyber attacks?" (L'organisation ORG et les entreprises comparables sont-elles exposées aux cyberattaques ?)
- Q2 (Développements politiques/économiques) :"What are major economic or political developments in ORGCOUNTRY that could affect businesses?" (Quels sont les développements économiques ou politiques majeurs dans ORGCOUNTRY [nom du pays] susceptibles d'avoir un impact sur les entreprises ?)
- Q3 (Changements réglementaires) :"What regulations or policy changes have recently impacted ORG in ORGCOUNTRY?" (Quels changements réglementaires ou évolutions des politiques publiques ont récemment affecté l'organisation ORG dans le pays ORGCOUNTRY ?)
- Q4 (Controverses internes) :"Has ORG been involved in any controversies, leadership changes, or restructuring?" (L'organisation ORG a-t-elle fait l'objet de controverses, de changements au sein de sa direction ou de mesures de restructuration ?)
- Q5 (Conflits étatiques) :"Are there known conflicts between ORGCOUNTRY and other nations that might influence cyber or economic targeting?" (Y a-t-il des tensions ou conflits avérés entre le pays ORGCOUNTRY et d'autres États pouvant inciter à des actions de ciblage cybernétique ou économique ?)
- Q6 (Attention médiatique) :"Has ORG received significant public or media attention recently that could attract adversarial interest?" (L'organisation ORG a-t-elle fait l'objet d'une couverture médiatique ou d'une exposition publique récente significative pouvant susciter l'intérêt d'acteurs malveillants ?)
Une étude d'ablation de type leave-one-out démontre l'importance relative de ces requêtes : les requêtes Q1 (évaluation directe du risque cyber) et Q3 (évolutions réglementaires nationales) se révèlent être les plus critiques. La suppression de l'une ou l'autre de ces deux requêtes entraîne une chute de 4,2 % du ROC AUC du modèle.
4. Stratégies de fusion des données : Traitement hybride texte et télémétrie
Afin de combiner l'analyse contextuelle de la motivation (capturée par le texte) et l'évaluation de la faisabilité technique (mesurée par le réseau), deux architectures de fusion de données ont été développées.
1. Input Fusion (Fusion à l'entrée)
L'approche Input Fusion enrichit l'invite textuelle (prompt) transmise au LLM en y intégrant des indicateurs macro-économiques et sociétaux issus de la base GDELT (Global Database of Events, Language, and Tone).
- Normalisation : Pour chaque pays et chaque mois, les métriques brutes (événements de conflit matériel, volume total d'événements, mentions médiatiques) sont transformées en z-score par rapport aux 30 mois précédents, puis bornées dans l'intervalle (-1, 1) par une fonction tanh. La pertinence de ce signal est étayée par la corrélation de Pearson observée entre le volume de mentions médiatiques GDELT et le nombre mensuel de cyber-incidents (notamment ρ = 0,616 pour l'Ukraine et ρ = 0,558 pour la Russie).
- Discrétisation : Les scores sont convertis en descriptions textuelles catégorisées en 5 intensités (de "unusually low" à "unusually high") et jointes directement au contexte RAG.
2. Hybrid Fusion (Fusion hybride intermédiaire)
L'architecture Hybrid Fusion associe l'enrichissement du prompt (Input Fusion) à une concaténation au niveau des représentations vectorielles intermédiaires, couplée à un classificateur dédié.
Description textuelle et paramètres de l'architecture :
- Vecteurs d'entrée : Un vecteur textuel géopolitique de 4096 dimensions (issu de la couche 23 de
LLaMA-2-7Balimenté par le RAG et GDELT) et un vecteur de télémétrie réseau de 200 dimensions (incluant les métriques statiques de mauvaise gestion et les séries temporelles BLAG). - Projection et Alignement : Les deux vecteurs sont projetés dans un espace vectoriel partagé et normalisés afin d'aligner leurs échelles relatives et de compenser la dissymétrie dimensionnelle (4096 vs 200).
- Mécanisme de Porte Pondérée (Sigmoid Gating Layer) :Les représentations projetées sont concaténées (total de 4296 dimensions) et traversent une couche linéaire avec activation sigmoïde. Cette couche calcule un poids ∈ [0, 1]
- appliqué élément par élément sur le vecteur concaténé.
- Propriété d'initialisation : La couche linéaire de la porte est initialisée avec un biais positif. Cette configuration garantit qu'au début de l'entraînement, le modèle conserve l'intégralité des 4296 dimensions. Lors de la rétropropagation du gradient, le réseau apprend progressivement à réduire le poids des dimensions bruyantes de chaque modalité.
- Classificateur MLP : Le vecteur pondéré alimente un perceptron multicouche (MLP) comprenant 3 couches cachées de 256 neurones chacune, séparées par des fonctions d'activation GELU. La sortie est produite par une fonction sigmoïde entraînée par entropie croisée binaire.
5. Évaluation empirique des performances prédictives
L'évaluation empirique repose sur un protocole temporel strict afin de prévenir tout biais de fuite de données (data leakage). L'ensemble de test est constitué exclusivement de données issues des années 2024 et 2025, strictement postérieures à la date de coupure de pré-entraînement de LLaMA-2-7B (septembre 2022). Le jeu de test comprend 16 954 enregistrements (7 120 organisations victimes et 9 834 non-victimes).
Performances comparatives à l'horizon tactique (\tau = 30 jours)
Le tableau ci-dessous présente les aires sous la courbe ROC (ROC AUC) ainsi que les intervalles de confiance (IC) à 95 % obtenus pour les différentes configurations :
Architecture et données intégrées | ROC AUC | Intervalle de confiance |
Données géopolitiques seules ( | 71,4 % | [0,689, 0,737] |
Télémétrie réseau seule (Random Forest / Baseline Liu et al.) | 74,4 % | [0,721, 0,765] |
Télémétrie réseau seule (Classificateur MLP) | 77,5 % | [0,755, 0,795] |
Fusion d'entrée (Input Fusion : Geopolitical + GDELT) | 72,1 % | [0,696, 0,745] |
Fusion Hybride (Hybrid Fusion : Geopolitical + GDELT + Network MLP) | 81,3 % | [0,790, 0,833] |
Performance à l'horizon stratégique (τ = 1 an)
Évaluée sur une fenêtre de prédiction d'un an, l'approche intégrée conserve sa supériorité prédictive :
- Fusion Hybride (τ = 1 an) : ROC AUC de 78,6 % (95 % IC :
[0,763, 0,809]) - Télémétrie Réseau MLP (τ = 1 an) : ROC AUC de 77,3 % (95 % IC :
[0,740, 0,806]) - Fusion d'entrée (τ = 1 an) : ROC AUC de 70,2 % (95 % IC :
[0,675, 0,730])
Analyse contextuelle de l'apport des données géopolitiques
L'analyse des taux de vrais positifs (TPR au F1-score maximal) selon les métadonnées de la base CISSM indique les contextes d'efficacité maximale des signaux géopolitiques textuels :
- Typologie d'attaquants : Le modèle géopolitique seul prédit avec une précision nettement supérieure les attaques perpétrées par des États-nations (Nation-State) et des hacktivistes (TPR de 60/64 et 92/98) par rapport aux attaques menées par des cybercriminels opportunistes (TPR de 728/798).
- Motivations d'attaque : Les incidents motivés par le sabotage (TPR: 30/30) et la protestation (TPR: 102/107) affichent les taux de détection les plus élevés, surpassant les attaques à finalité financière (TPR: 725/792) ou d'espionnage politique (TPR: 27/32).
- Secteurs d'activité : Les organisations des secteurs de la santé et de l'éducation présentent une prédictibilité légèrement supérieure via les sources géopolitiques par rapport aux autres branches industrielles.
6. Sensibilité aux sources d'information et impact de la notoriété des domaines
L'analyse du corpus d'extraction RAG met en évidence une forte concentration du signal informatif au sein des médias de grande notoriété.
- Poids des domaines majeurs : Les sites web figurant dans le Top 10k du classement Tranco (ex: Yahoo News) représentent entre 20 % et 40 % des articles effectivement sélectionnés par le système RAG pour constituer le prompt du LLM. Ces domaines ne constituent pourtant que 1 % à 5 % de l'ensemble des documents du corpus brut
CC-NEWS. - Impact du filtrage strict : Lorsque l'étape de recherche RAG est restreinte exclusivement aux sources du Top 10k Tranco, la capacité prédictive du modèle géopolitique seul subit une baisse marginale, passant de 71,4 % à 69,6 % ROC AUC.
Enseignement opérationnel : Il n'est pas nécessaire d'ingérer des sources d'information obscures, instables ou sujettes aux manipulations de l'information pour alimenter le modèle prédictif. Les flux de presse à forte visibilité concentrent l'essentiel des signaux précurseurs pertinents.
7. Limites méthodologiques et biais d'évaluation
Une évaluation rigoureuse de la méthodologie impose de prendre en compte plusieurs biais et contraintes expérimentales :
- Biais de déclaration des incidents : La sous-déclaration structurelle des cyber-attaques dans les bases de données publiques (notamment pour les entités de taille moyenne) peut conduire à une sous-estimation du rappel (TPR) et à la présence de fausses non-victimes dans les jeux de données.
- Qualité de la datation des incidents : L'application de la base CSIDB comme couche corrective sur la base CISSM a permis d'ajuster 29,8 % des dates d'incidents (avec un décalage temporel médian de 25 jours par rapport à la date de publication de l'article). Un audit manuel sur 48 incidents a confirmé que cette correction a porté la précision de la datation de 77,1 % à 91,7 % sur l'ensemble du corpus, et à 96,96 % sur le sous-ensemble d'intersection (33 cas présents simultanément dans CISSM et CSIDB).
- Biais de couverture médiatique : Les grandes entreprises et les infrastructures critiques font l'objet d'un suivi médiatique plus dense. Le modèle présente ainsi une sensibilité supérieure pour les entités à forte visibilité par rapport aux organisations opérant hors du champ médiatique.
- Précision du cartographiage réseau (Mapping CISSM-RIR) : L'attribution automatisée des plages d'adresses IP aux organisations via les registres RIR (ARIN, RIPE, APNIC, AFRINIC) a atteint une précision de 89,86 % (IC de Wilson à 95 % :
[0,84, 0,94], évaluée sur un échantillon auditable de 148 paires). - Biais d'appellation des entités (Name Bias) : L'évaluation révèle qu'un classificateur linéaire basé sur les 1-grammes des noms d'organisations obtient à lui seul un ROC AUC de 0,815, en raison de biais légués par la nomenclature des bases publiques. Certains termes présentent de fortes régression positives vers le statut de victime (ex: health +3,711, company +3,260, healthcare +3,232, hospital +3,059, university +2,390, ministry +2,008), tandis que d'autres régressent fortement vers le statut de non-victime (ex: beijing -3,320, computer -2,104, stichting -2,041, kommune -1,908, ibm-1,536).
- Correction expérimentale : Pour empêcher le modèle d'exploiter cette séparabilité artificielle, une stratégie d'échantillonnage sémantique sélectif des non-victimes a été appliquée, forçant le réseau à ignorer les artefacts lexicaux au profit des variations temporelles du contexte géopolitique.
8. Conclusion et enseignements pour la modélisation du risque cyber
Cette étude confirme la valeur prédictive de l'information géopolitique non structurée (presse écrite et podcasts), extraite via des modèles de langage et un système RAG, pour l'anticipation du cyber-risque. Si la télémétrie réseau demeure indispensable pour établir la faisabilité technique d'une attaque en évaluant l'hygiène informatique d'une organisation, elle s'avère incapable de mesurer l'émergence des motivations ennemies.
L'architecture d'intégration hybride (Hybrid Fusion), combinant la représentation sémantique géopolitique (LLM + GDELT) et les métriques de surface réseau au sein d'un classificateur à porte pondérée, établit un niveau de performance supérieur (81,3 % de ROC AUC à 30 jours et 78,6 % à 1 an), surpassant les méthodes fondées uniquement sur la télémétrie d'infrastructure (77,5 % et 77,3 %).
Ces résultats démontrent l'intérêt de coupler des sources d'information hétérogènes et indépendantes pour constituer des indicateurs avancés (leading indicators), applicables tant au pilotage opérationnel des centres d'opérations de sécurité (SOC) qu'à la tarification dynamique du risque en souscription d'assurance cyber.