Gestion du Risque de Modèle des LLM par Simulation Monte-Carlo
Source : Garcia-Lorite, D., & Merino, R. (2026). A distributional framework for behavioral characterization and risk management of large language models. arXiv.
Sommaire : L'intégration des grands modèles de langage (LLM) dans les institutions financières bouleverse la gestion du risque de modèle (MRM) en raison de leur nature stochastique.
Pour dépasser l'incertitude des modèles traditionnels, l'article propose un cadre empirique fondé sur des simulations Monte-Carlo. Cette méthodologie modélise la distribution des réponses, évalue la sensibilité sémantique et la dérive comportementale, tout en mesurant l'efficacité des garde-fous.
Incapable d'être cadrée par les approches déterministes classiques, cette méthode non intrusive permet d'auditer les modèles « boîte noire », d'assurer la conformité réglementaire (EU AI Act) et d'objectiver la gouvernance des IA en production.
1. Introduction et Cadre Réglementaire du Risque de Modèle (MRM)
L'intégration des grands modèles de langage (LLM) dans les processus décisionnels des institutions financières introduit un changement de paradigme fondamental pour les spécialistes de la gouvernance et de la gestion du risque de modèle (Model Risk Management - MRM). Le problème central réside dans la nature intrinsèquement stochastique de ces architectures : l'exécution répétée d'un LLM sous des conditions expérimentales rigoureusement identiques peut générer des réponses variables. Cette variabilité pose un défi direct aux méthodologies de validation traditionnelles conçues pour des algorithmes déterministes.
En modélisation quantitative classique (score d'octroi, modèles de risque de marché ou de crédit), la conception privilégie la parsimonie, la transparence et l'existence d'une structure explicite. Ces caractéristiques permettent une analyse de sensibilité analytique, une traçabilité parfaite des sorties et des tests de résistance (stress tests) déterministes. À l'inverse, le comportement des LLM est émergent et issu d'interactions contextuelles et sémantiques hautement complexes. Le modèle ne s'appuie pas sur une équation fermée mais sur un réseau de paramètres massifs réagissant à des nuances de formulation, ce qui rend l'anticipation de ses défaillances particulièrement ardue.
Au niveau normatif et prudentiel, le cadre de gouvernance évolue rapidement pour tenter d'encadrer ces technologies :
- Les directives prudentielles financières : Historiquement ancrée dans la circulaire américaine SR 11-7 (2011), la régulation prudentielle a franchi une étape avec la publication de la directive révisée SR 26-2 (2026). Toutefois, la circulaire SR 26-2 exclut explicitement et temporairement l'IA générative et les systèmes agentiques de son périmètre d'application strict. La raison invoquée par les régulateurs réside dans l'évolution technologique extrêmement rapide et la maturité insuffisante des normes de validation, qui empêchent à ce stade d'établir des standards prudentiels stables et pérennes.
- Les cadres réglementaires et normatifs généraux : À l'échelle internationale, la conformité s'articule désormais autour du Règlement européen sur l'IA (EU AI Act, 2024), qui impose des exigences légales contraignantes d'explicabilité et de gestion des risques pour les systèmes à haut risque, et du cadre de gestion des risques du NIST (NIST AI RMF, 2023), qui fournit une structure méthodologique pour piloter la fiabilité, la sécurité et la neutralité des systèmes d'IA.
Dans ce contexte d'incertitude réglementaire et technique, l'objectif de ce document est d'exposer un cadre empirique rigoureux, fondé sur des simulations Monte-Carlo. Conçu pour les auditeurs et les responsables du risque de modèle, ce cadre permet de caractériser formellement la distribution de probabilité des réponses des LLM, de mesurer leur sensibilité sémantique, d'évaluer quantitativement l'efficacité des contrôles de mitigation et de surveiller le comportement résiduel du modèle tout au long de son cycle de vie.
2. Cadre Méthodologique : Caractérisation par Simulation Monte-Carlo
Dans un modèle de langage, le processus de génération de texte s'effectue jeton par jeton (token par token). Pour une invite (prompt) donnée, le LLM ne produit pas une réponse unique de manière déterministe, mais échantillonne chaque jeton depuis une distribution de probabilité conditionnelle déterminée par les poids du modèle, la température de décodage T, l'invite initiale et la séquence de jetons déjà générés. Une réponse textuelle observée n'est donc qu'une réalisation particulière d'une variable aléatoire multidimensionnelle.
Afin de caractériser la distribution empirique sous-jacente sous des conditions expérimentales données, nous mettons en œuvre un protocole de simulation Monte-Carlo structuré en 6 étapes ordonnées :
- Définir la tâche : Identifier explicitement la fonction métier ou le problème analytique à évaluer.
- Sélectionner le modèle : Fixer la version exacte de l'architecture du modèle de langage (ex.
gemini-3.1-flash-lite). - Fixer la configuration : Arrêter le prompt, les paramètres de décodage (température T, top-p) et les conditions d'administration.
- Exécuter les simulations : Instancier N exécutions indépendantes de la tâche via l'API. Chaque tirage doit être effectué avec une instance client vierge, exempte de tout historique ou contexte conversationnel partagé.
- Collecter les données : Archiver l'ensemble des N réponses brutes obtenues.
- Estimer la distribution empirique : Calculer la fréquence relative d'apparition de chaque catégorie de réponse et construire le vecteur de probabilité correspondant.
Un obstacle majeur réside dans la variabilité linguistique : un LLM peut exprimer une idée strictement identique à l'aide de formulations syntaxiques différentes. Sans traitement, cette diversité textuelle provoque une fragmentation artificielle de la distribution de probabilité. Il est donc indispensable d'introduire une fonction d'appariement (mapping) M : ℛ → 𝒞, qui projette l'espace des réponses textuelles brutes ℛ vers un espace restreint de réponses canoniques 𝒞. Ce mapping peut être manuel ou automatisé (règles déterministes, clustering vectoriel ou évaluation sémantique par un LLM juge).
D'un point de vue de la gouvernance, la fonction d'appariement M constitue elle-même un composant de modèle sujet au risque de modèle. Une fonction de mapping mal spécifiée peut masquer une dérive comportementale ou, inversement, créer une instabilité artificielle. La validation de M est donc un prérequis obligatoire au dispositif de mesure.
Sur le plan géométrique, l'ensemble des réponses canoniques observées d de dimension finie définit un simplex de probabilité :
Δᵈ⁻¹ = { p ∈ ℝᵈ : ∑ᵢ₌₁ᵈ pᵢ = 1, pᵢ ≥ 0 }
Chaque simulation Monte-Carlo produit un vecteur de probabilité empirique p̂ qui constitue un point unique localisé au sein de ce simplex Δᵈ⁻¹.
3. Métriques Distributionnelles et Quantitatives du Risque
Afin de caractériser la structure des distributions empiriques et de mesurer précisément les écarts entre deux états du modèle (par exemple entre la baseline et une intervention), nous définissons un jeu de métriques quantitatives. Conformément aux exigences de formatage, l'ensemble des expressions ci-dessous est rédigé en texte plain Unicode.
- Probabilité empirique : Pour une catégorie de réponse canonique rᵢ observée nᵢ fois au cours de N réalisations Monte-Carlo : p̂_i = n_i / N
- Support observé (K_obs) : Cardinal de l'ensemble des catégories canoniques distinctes générées sur N tirages. Il mesure la diversité empirique et dépend de la taille de l'échantillon N.
- Vecteur de probabilité : Point p̂ appartenant au simplex de probabilité : p̂ = (p̂₁, p̂₂, ..., p̂_K_obs), vérifiant ∑ᵢ₌₁^{K_obs} p̂ᵢ = 1
- Entropie de Shannon : Mesure le degré de dispersion ou d'incertitude de la masse de probabilité sur le support observé : H(p̂) = - ∑ᵢ₌₁^{K_obs} p̂ᵢ log₂(p̂ᵢ). Une entropie nulle traduit un comportement parfaitement déterministe (100 % de la masse sur une seule catégorie). Le nombre effectif de catégories de réponses équivalentes est donné par 2ᴴ⁽ᵖ̂⁾.
- Distance en Variation Totale (D_TV) : Mesure la distance probabiliste directe entre deux distributions empiriques p̂ et q̂ définies sur un support commun K (où K = Kₚ ∪ K_q représente l'union des supports observés, les catégories non observées dans l'une des distributions étant complétées par pᵢ = 0 ou qᵢ = 0) : D_TV(p̂, q̂) = (½) ∑ᵢ₌₁ᴷ |p̂ᵢ - q̂ᵢ| La distance D_TV est strictement bornée entre 0 (distributions identiques) et 1 (supports totalement disjoints).
- Divergence de Jensen-Shannon (D_JS) : Métrique d'information symétrique et bornée, dérivée de la divergence de Kullback-Leibler (D_KL) par rapport à la distribution moyenne m = (p̂ + q̂) / 2 : D_JS(p̂, q̂) = (½) D_KL(p̂ ∥ m) + (½) D_KL(q̂ ∥ m) La divergence D_KL entre deux distributions a et b est définie par : D_KL(a ∥ b) = ∑ᵢ₌₁ᴷ aᵢ log₂(aᵢ / bᵢ) Par convention, les termes où aᵢ = 0 apportent une contribution nulle à la somme. En utilisant le logarithme en base 2, la divergence vérifie 0 ≤ D_JS(p̂, q̂) ≤ 1, où 1 indique des distributions aux supports orthogonaux.
- Probabilité d'issues indésirables (P_U) : Soit U ⊂ 𝒞 le sous-ensemble des réponses canoniques jugées erronées, non conformes ou risquées du point de vue métier. La masse de probabilité indésirable s'exprime par : Pᵤ(p̂) = ∑ᵢ: ᵣᵢ ∈ U p̂ᵢ
- Perte attendue pondérée par la sévérité (L) :En associant une matrice de coût ou de sévérité financière/opérationnelle
Cᵢ à chaque résultat rᵢ, la perte attendue du modèle s'écrit : L(p̂) = ∑ᵢ₌₁^{K_obs} p̂ᵢ Cᵢ
4. Application au Cycle de Vie du Modèle et à la Gouvernance
4.1. Phase de Pré-production et Analyse de Sensibilité Sémantique
En phase de conception et de validation ex-ante, l'équipe de validation doit établir la distribution de référence (baseline) p̂_{baseline} sous des conditions opérationnelles standards, puis mesurer sa résilience face à des interventions sémantiques. Ces interventions consistent à altérer délibérément le prompt d'entrée pour cartographier le profil de sensibilité du LLM.
Catégorie d'intervention | Description opérationnelle |
Variations proches | Reformulations syntaxiques ou synonymiques légères du prompt original, conservant l'intégralité du sens. |
Interactions plausibles | Formulations alternatives reflétant la diversité réelle des saisies par les utilisateurs en conditions réelles. |
Interactions démographiques | Ajout d'attributs démographiques (genre, âge, nationalité) pour mesurer les dérives distributionnelles. |
Scénarios de stress | Prompts intégrant des contraintes de longueur extrêmes, des formulations ambiguës ou des requêtes contradictoires. |
Du point de vue de la gouvernance des risques, il est crucial de formaliser la distinction théorique entre biais et discrimination :
- Le biais correspond à une modification statistiquement significative de la distribution empirique p̂ sous l'effet d'une variation d'un attribut d'entrée (ex. le genre ou l'âge).
- La discrimination apparaît lorsque ce décalage distributionnel entraîne une dégradation ciblée des décisions, mesurée par une augmentation de la probabilité d'issues défavorables Pᵤ ou de la perte attendue L pour un groupe protégé spécifique.
Exemple concret d'octroi de crédit : Si l'ajout de l'attribut démographique "Femme" dans le prompt modifie la distribution des réponses du LLM (biais), et que cette modification se traduit par une hausse du taux de rejet injustifié du dossier de prêt (augmentation de Pᵤ, entraînant une discrimination financière), le modèle présente un risque de non-conformité majeur au regard des exigences de l'EU AI Act et des normes de crédit équitable (Fair Lending).
4.2. Évaluation de l'Efficacité des Contrôles et Comportement Résiduel
Pour atténuer les risques identifiés, des gardes-fous (guardrails, consignes de restriction) sont intégrés au dispositif. Le cadre Monte-Carlo permet de mesurer l'efficacité de ces contrôles en comparant la distribution initiale sans contrôle p̂^(0) à la distribution observée après application du contrôle p̂⁽ᶜ⁾.
Les métriques d'efficacité des contrôles sont formalisées ainsi :
- Réduction absolue du risque indésirable : ΔPᵤ⁽ᶜ⁾ = Pᵤ⁽⁰⁾ - Pᵤ⁽ᶜ⁾
- Efficacité relative du contrôle : Eᵤ⁽ᶜ⁾ = 1 - (Pᵤ⁽ᶜ⁾ / Pᵤ⁽⁰⁾), définie pour Pᵤ⁽⁰⁾ > 0
- Réduction de la perte attendue : ΔL⁽ᶜ⁾ = L⁽⁰⁾ - L⁽ᶜ⁾
Mise en garde de gouvernance (Déstabilisation par contrôle) : L'introduction d'un garde-fou n'est pas neutre sur la dynamique du modèle. Les tests empiriques révèlent que certains contrôles restrictifs peuvent embrouiller le LLM, créant une dispersion inattendue de la masse de probabilité vers d'autres catégories d'erreurs, augmentant ainsi de manière contre-intuitive la masse de probabilité indésirable Pᵤ⁽ᶜ⁾ ou la perte résiduelle ΔL⁽ᶜ⁾. La validation d'un contrôle exige donc une vérification stricte que Eᵤ⁽ᶜ⁾ > 0.
4.3. Surveillance Continue en Production (Ongoing Monitoring)
En phase d'exploitation, les journaux d'exécution (production logs) alimentent une boucle de rétroaction (feedback loop). Les requêtes réelles des utilisateurs sont regroupées en classes sémantiques et comparées en continu aux baselines validées.
La dérive comportementale (drift) au cours du temps t pour une condition j donnée est suivie via les distances distributionnelles :
Dₜ,ⱼ = D(p̂ₜ,ⱼ, p̂ₜ₋₁,ⱼ) ou Dₜ,ⱼ = D(p̂ₜ,ⱼ, p̂₀,ⱼ) où D représente la distance D_TV ou la divergence D_JS.
Cette approche présente un avantage stratégique déterminant pour la gestion des risques : elle est totalement non intrusive. Ne nécessitant aucun accès aux poids internes du modèle, aux gradients ou aux log-probabilités des jetons, elle s'applique parfaitement à la gouvernance des modèles dits « boîte noire », hébergés par des tiers et accessibles uniquement via des API commerciales.
5. Études de Cas Empiriques et Résultats
5.1. Classification du Risque Emprunteur (Cas avec Vérité Terrain)
L'expérience évalue la capacité du modèle gemini-3.1-flash-lite à classifier le niveau de risque financier d'un dossier de prêt en se basant sur des règles explicites intégrées dans l'invite.
- Profil de l'emprunteur : Revenu annuel : 60 000 €, Dette annuelle : 24 000 € (soit un ratio DTI = 40 %), 0 retard de paiement.
- Règles de décision : Risque Faible (DTI < 30 % et 0 retard) ; Risque Moyen (DTI entre 30 % et 50 %, ou 1 retard) ; Risque Élevé (DTI > 50 %, ou ≥ 2 retards).
- Vérité Terrain (Ground Truth) : La catégorie théorique exacte est Risque Moyen.
L'expérience compare 5 variantes d'invites (Prompts 1 à 5) pour N = 100 simulations Monte-Carlo sous des températures T ∈ {0,8 ; 1,3 ; 2,0}.
Les 5 variantes de consignes ajoutées au profil emprunteur sont :
- Prompt 1 : "Calculate the DTI. Classify the borrower as Low, Medium, or High risk. Answer only with the category."
- Prompt 2 : "Classify the borrower as Low, Medium, or High risk. Answer with the classification and, on the next line, explain why."
- Prompt 3 : "Classify the borrower as Low, Medium, or High risk. Review the DTI and answer only with the classification level."
- Prompt 4 : "Classify the borrower as Low, Medium, or High risk. Calculate DTI. Classify the risk. Answer only with the classification level."
- Prompt 5 : "Answer with the DTI percentage on one line and the classification level on another line."
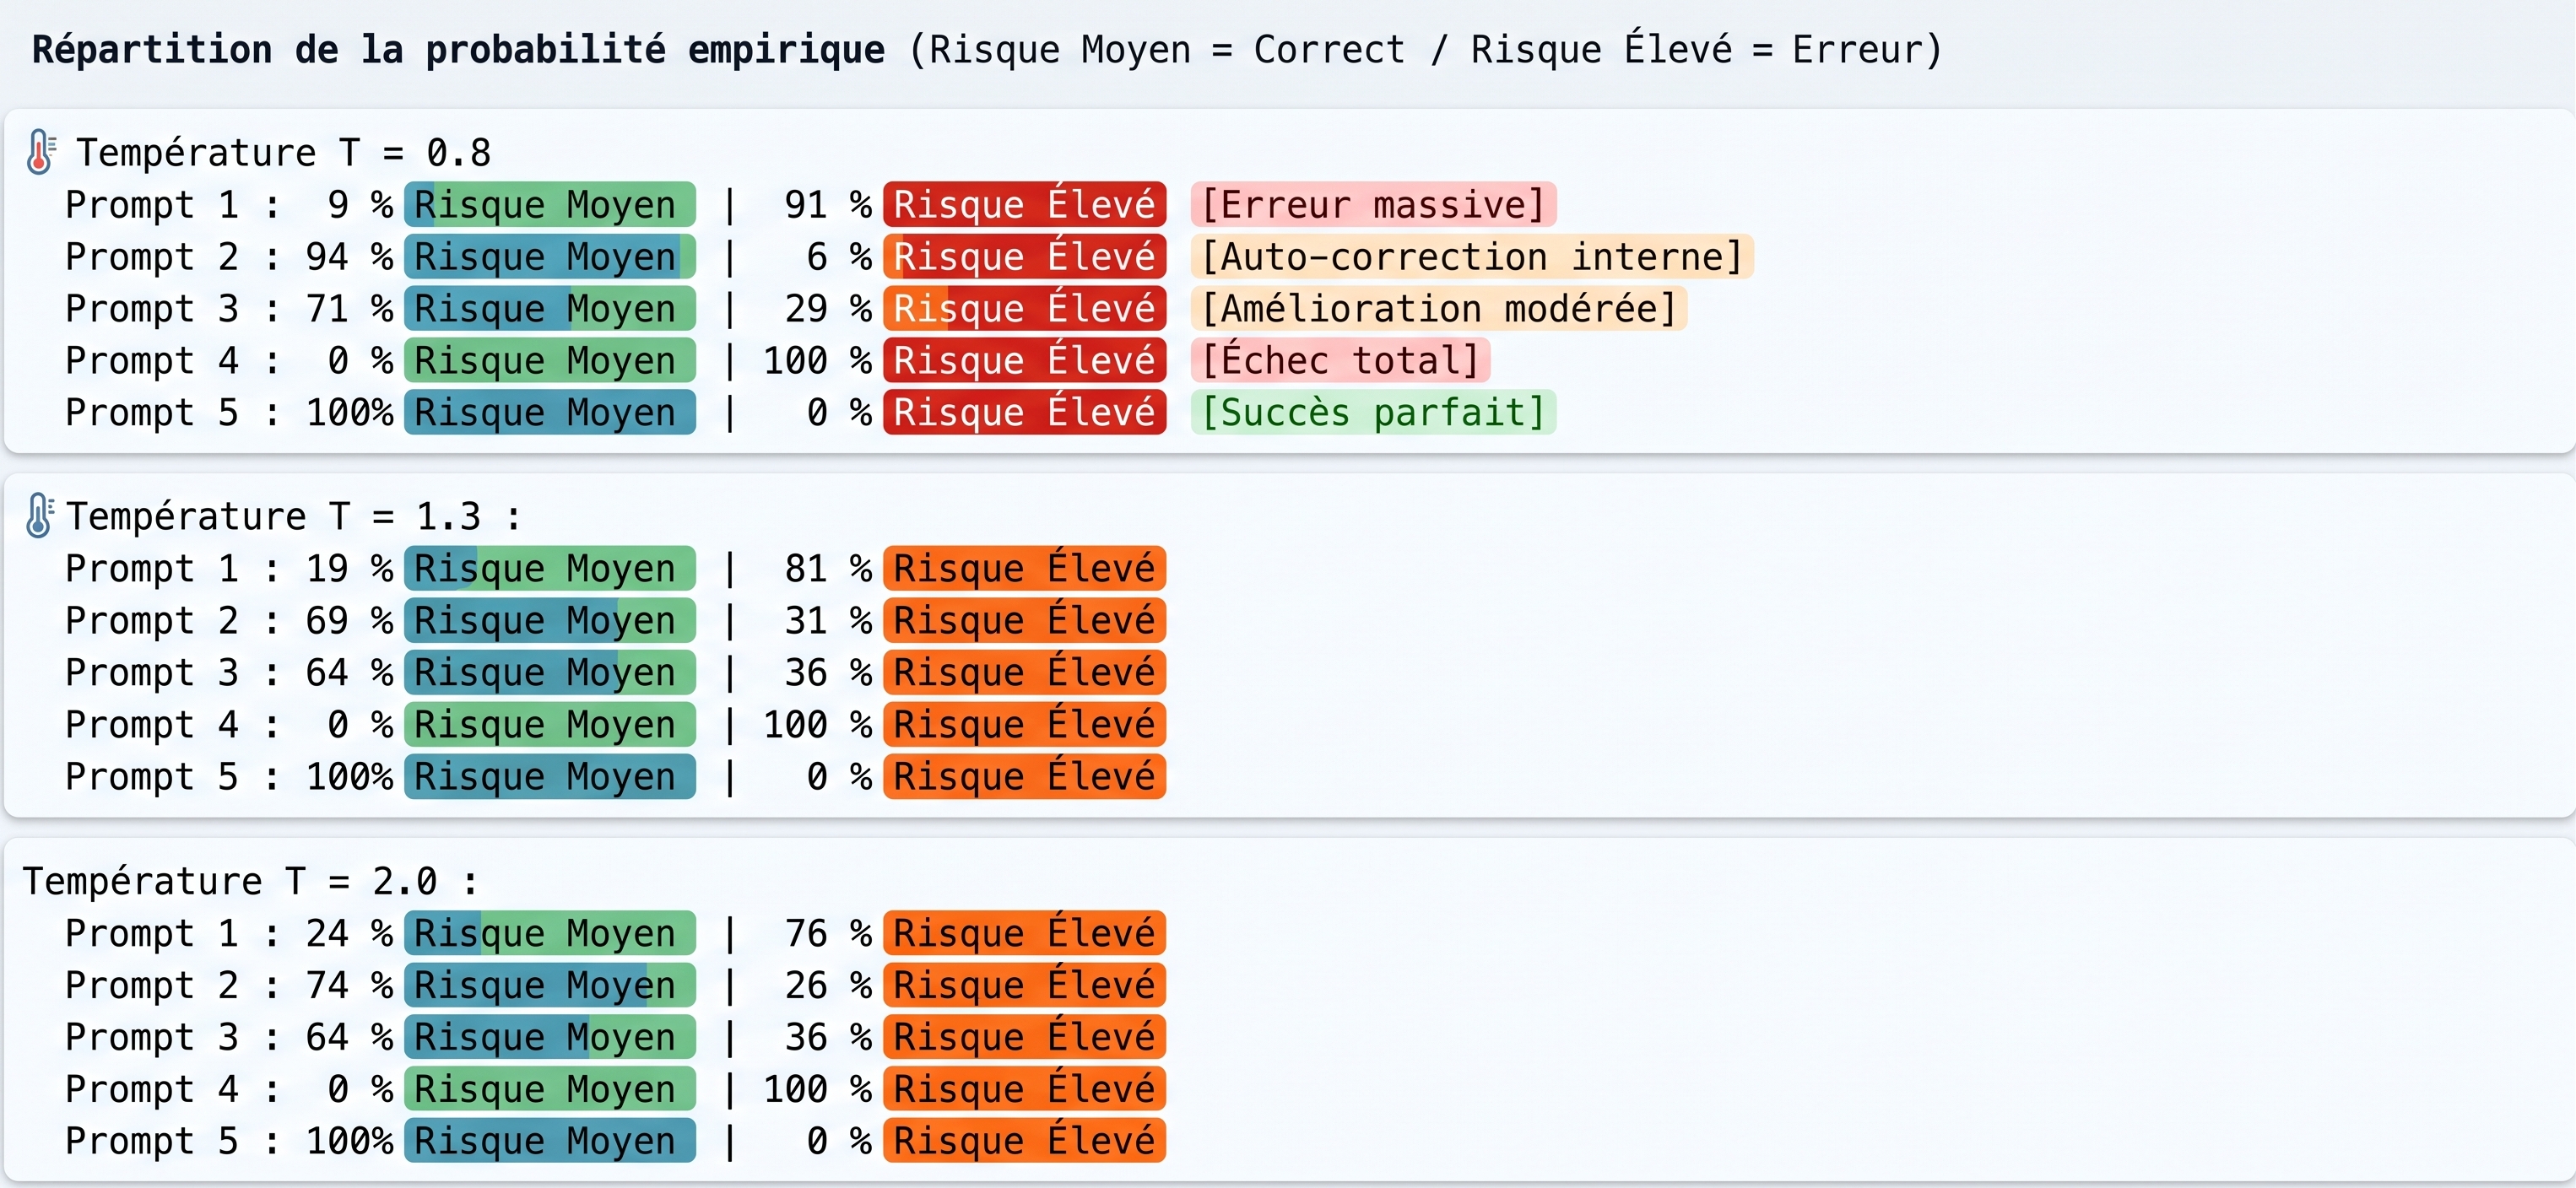
L'inclusion du Prompt 3 fournit un enseignement clé pour l'ingénierie des invites : l'ajout d'une instruction explicite de révision ("Review the DTI") permet d'élever le taux de réussite à 71 % (à T=0,8) par rapport au Prompt 1 (9 %). Cependant, cette incitation à la relecture reste nettement inférieure à la performance du Prompt 2 (94 %) et ne parvient pas à égaler le déterminisme parfait du Prompt 5 (100 %).
L'analyse qualitative des sorties du Prompt 2 met en lumière un phénomène d'auto-correction interne au sein du jeton d'explication. Dans plusieurs tirages, le modèle formule une réponse initiale erronée avant de se corriger dans le corps du texte : "High risk... The borrower's DTI is 40%... Correction based on your exact classification rules: Medium risk". Ce comportement démontre l'impact critique du système d'appariement M : si la fonction de mapping n'évalue que la toute première mention textuelle, l'exactitude mesurée pour le Prompt 2 est de 94 % à T=0,8 ; si elle évalue le contexte sémantique complet de la réponse canonique finale, la précision atteint 100 %.
5.2. Recommandation d'Albums de Musique (Analyse de Sensibilité et Interventions Sémantiques)
L'expérience étudie la tâche de recommandation du meilleur album de musique ("Groupe - Album") par le modèle gemini-3.1-flash-lite pour N = 50 réalisations et T ∈ {0,8 ; 1,3 ; 2,0}.
- Écart avec la question ouverte : Dans une interrogation sans contrainte ("What is the best music album ever?"), le modèle génère des listes ordonnées dominées par Sgt. Pepper's Lonely Hearts Club Band (The Beatles). L'album The Dark Side of the Moon (TDSM, Pink Floyd) n'y apparaît qu'en 3e ou 4e position.
- Baseline contrainte : Dès que la tâche exige une réponse unique ("Answer Band - Album. No explanation."), le support s'effondre dramatiquement sur deux albums seulement : TDSM devient le leader incontesté (82 % à 90 % de probabilité selon T) et Abbey Road s'empare du solde (10 % à 18 %).
Pour classifier le comportement des interventions sémantiques par rapport à cette baseline, nous définissons un seuil de tolérance sur la variation de probabilité δ = 0,06 (correspondant à un écart d'au moins 3 observations sur N = 50 tirages) :
- Reinforced : Le leader reste identique et sa probabilité augmente de plus de δ.
- Preserved : Le leader reste identique et sa probabilité varie de moins de δ.
- Weakened : Le leader reste identique mais sa probabilité diminue de plus de δ.
- Competition : L'écart de probabilité entre les deux premiers albums devient inférieur ou égal à δ.
- Displaced : Un nouvel album devient le leader de la distribution.
L'évaluation quantitative des interventions sémantiques fournit les métriques clés suivantes :
- Démographie (Genre et Âge) :
- Genre : La condition féminine à T=0,8 concentre 100 % de la masse de probabilité sur TDSM (p̂ = 1,000, D_TV = 0,100, D_JS = 0,052), classée comme Reinforced.
- Âge : L'augmentation de l'âge (de 20 à 90 ans) montre une transition continue. Entre 20 et 50 ans, TDSM domine à près de 100 %. Entre 60 et 70 ans, un basculement s'opère : Abbey Road prend le dessus pour atteindre plus de 90 % chez les centenaires. L'entropie H(p̂) atteint son maximum à 65 ans (H ≈ 1,0), marquant une zone d'incertitude maximale.
- Nationalité :
- Américaine : À T=0,8, la condition déplace le leader vers Abbey Road (p̂ = 0,640, D_TV = 0,540, D_JS = 0,245, comportement Displaced).
- Nigériane : La condition élargit le support observé en introduisant Expensive Shit de Fela Kuti et affaiblit TDSM (p̂ = 0,800 à T=0,8, D_TV = 0,200, D_JS = 0,152, comportement Weakened).
- Préférence Négative (Contrôle d'évitement) :
- L'instruction "I don't like The Dark Side of the Moon" s'avère extrêmement efficace : la probabilité de TDSM s'effondre à 0 % à T=0,8 (p̂(Abbey Road) = 0,860, D_TV = 0,900, D_JS = 0,769, Displaced) et plafonne à 4 % à T=1,3 et T=2,0 (D_JS = 0,645 et 0,579).
- À l'inverse, qualifier l'album de surestimé ("Overrated TDSM") échoue largement à l'éviter : TDSM conserve la tête de la distribution à 74 % à T=0,8 (D_TV = 0,160, D_JS = 0,032, Weakened).
- Goûts & Qualificatifs :
- "I love The Kinks" déplace massivement la distribution vers Village Green (p̂ = 0,920 à T=0,8, D_TV = 0,940, D_JS = 0,924, Displaced).
- L'ajout du qualificatif "underrated" agit de manière asymétrique selon le contexte d'artiste : appliqué à Tenacious D ou Bach, il ramene la distribution vers la baseline TDSM (p̂ = 1,000 pour TD Underrated, D_JS = 0,052, Reinforced ; p̂ = 0,900 pour Bach Underrated, D_JS = 0,040, Preserved). Appliqué à Pink Floyd ("PF Underrated"), il verrouille TDSM à 100 %.
5.3. Sensibilité aux Paramètres d'Échantillonnage et au Mode de Livraison du Contexte
- Taille d'échantillon Monte-Carlo (N) et Bootstrap : Une étude par ré-échantillonnage bootstrap (1 000 répliques avec remise sur une référence N = 300) a été menée sur deux distributions à T=2,0 : la Baseline (concentrée, K_obs = 2) et l'intervention "Don't like TDSM" (dispersée, K_obs = 11 à N=300). L'analyse des enveloppes de confiance au 95ème centile montre que si le support K_obs augmente avec N pour la condition dispersée (passant de 7 catégories à N=50 jusqu'à 11 à N=300), les probabilités des réponses principales ainsi que l'entropie H(p̂) se stabilisent dès N = 50 à 100 tirages. La médiane bootstrap de la distance D_TV par rapport à la référence N=300 s'abaisse sous 0,05 dès N=100. Cela prouve rigoureusement qu'un échantillon N de 50 à 100 tirages est suffisant pour caractériser le comportement central et mesurer les dérives, alors qu'un N très élevé n'est nécessaire que pour estimer la probabilité des événements rares dans les queues de distribution.
- Mode de livraison du contexte : Nous avons comparé 3 architectures d'administration de l'invite sous l'intervention Nigériane et la condition "Don't like TDSM"(N = 300, T = 2,0) :
- Deux messages séparés (Configuration de référence : Message 1 = Contexte utilisateur, Message 2 = Tâche).
- Un prompt unique (Condensation du contexte et de la tâche en un seul message).
- Téléversement de fichier (Téléversement d'un fichier Markdown contenant le contexte, suivi du prompt de tâche).
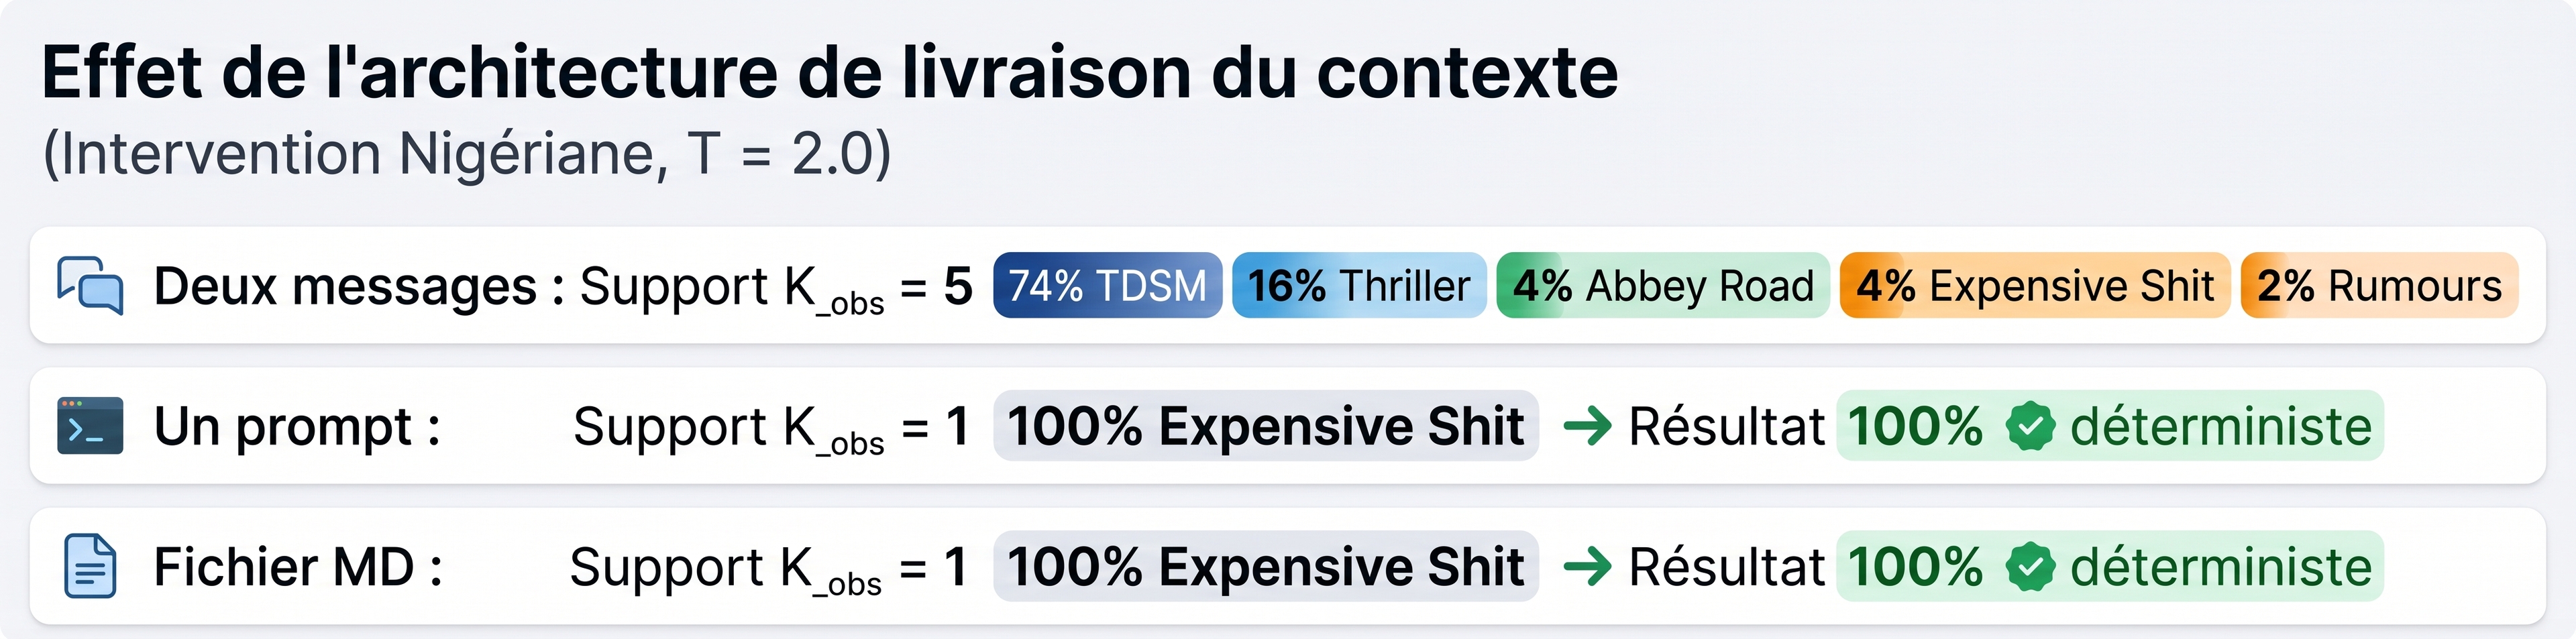
Ce résultat est fondamental pour les normes d'ingénierie d'invite et de gouvernance : la diversité stochastique observée dans une interaction multi-messages s'effondre totalement vers un choix 100 % déterministe lorsque les contraintes sont condensées dans un seul prompt ou transmises par fichier. Le mode de livraison du contexte constitue donc une condition expérimentale majeure qui doit être rigoureusement contrôlée lors de la validation.
- Réduction de support par mapping (Restriction de longueur) : L'expérience imposant une réponse en 20 mots illustre le rôle réducteur de la fonction d'appariement M. À T=0,8 sous la condition "Love music + 20 words + why", le support des réponses brutes atteint K_raw = 45 variations textuelles distinctes, mais s'effondre à un support canonique K_canonical = 2 après appariement sémantique.
6. Limitations Techniques et Recommandations
L'application du cadre distributionnel Monte-Carlo à la gestion du risque de modèle présente quatre limitations intrinsèques qu'il convient de garder à l'esprit lors des travaux de validation :
- Échantillonnage fini et événements rares : En raison de la taille finie de l'échantillon Monte-Carlo N, les événements à très faible probabilité situés dans les queues de distribution peuvent échapper à l'observation, masquant potentiellement des cas de défaillance rares mais sévères.
- Coût computationnel et financier : La conduite de simulations Monte-Carlo sous de multiples combinaisons d'interventions sémantiques et de températures nécessite la répétition de milliers d'appels API, générant des coûts d'infrastructure et une empreinte calculatoire significatifs.
- Incertitude liée au mapping sémantique : Le regroupement des réponses textuelles brutes sous des formes canoniques réintroduit une part de subjectivité ou de risque de modèle au niveau de la fonction d'appariement M, nécessitant un protocole d'audit dédié.
- Hypothèse d'indépendance statistique : L'indépendance stricte des tirages Monte-Carlo ne peut être formellement garantie lors de l'utilisation d'API propriétaires fermées opérant derrière des équilibreurs de charge (load balancers) ou des mécanismes de mise en cache interne.
Recommandations pour les comités de risque de modèle : En dépit de ces limitations, l'approche distributionnelle par simulation Monte-Carlo apporte une valeur opérationnelle décisive. Elle permet aux responsables des risques d'abandonner les évaluations qualitatives ou ponctuelles au profit d'une caractérisation géométrique, objective et répétable de la stochastique des LLM. Ce cadre constitue un outil prêt à l'emploi pour la qualification ex-ante des garde-fous, l'analyse de sensibilité discriminatoire et le suivi continu ex-post des modèles « boîte noire » déployés au sein du secteur financier.
