Système expert et deep learning pour la classification des sinistres cyber
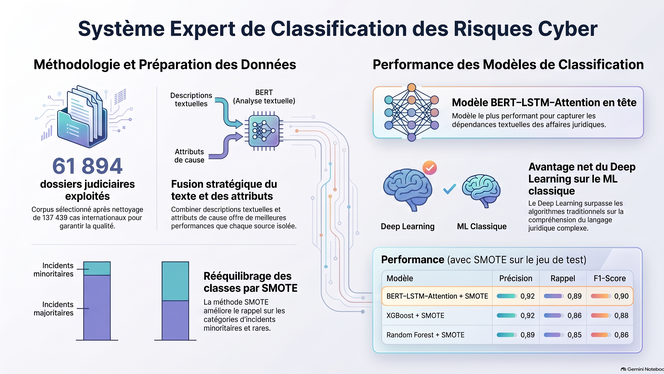
Face à l'incertitude et au manque d'historique en souscription cyber, cette étude propose un système expert fondé sur le deep learning pour classifier automatiquement 16 typologies d'incidents à partir des dossiers judiciaires américains (61 894 cas complets).
En associant variables structurées et narratifs textuels via une architecture BERT–LSTM–Attention couplée à la technique de rééquilibrage SMOTE, le modèle atteint un score F1 de 0,90 sur des données inédites (surpassant XGBoost et Random Forest).
Cette approche hybride surpasse la littérature NLP du domaine juridique. Elle permet d'automatiser le triage des sinistres et d'optimiser la gestion des risques, bien qu'un réétalonnage soit nécessaire hors du droit américain.