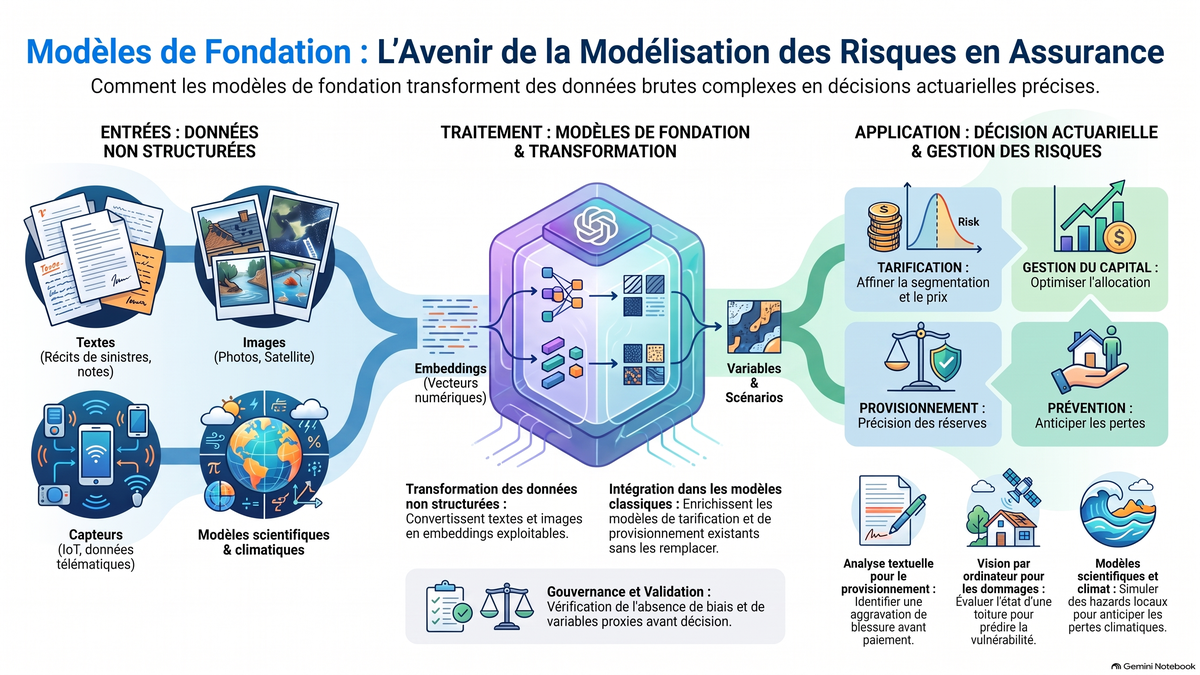
Foundation Models & assurance : transformer la modélisation des risques
Source : Blier-Wong, C. (2026). Towards foundation models for insurance risk modelling [Preprint]. University of Toronto.
Sommaire : Les Foundation Models (FM) transforment l'assurance en intégrant des données non structurées (textes, images, capteurs) aux modèles actuariels classiques (tarification, provisionnement, capital). Ils améliorent la détection des risques et la précision des prédictions, notamment pour les risques climatiques.
Cependant, leur adoption exige un cadre de gouvernance rigoureux. Pour préserver l'interprétabilité et la conformité prudentielle, les FM doivent s'insérer dans des architectures hybrides (ex. CANN). Les actuaires doivent encadrer des risques spécifiques : fuite temporelle, discriminations indirectes via les embeddings, surcoût computationnel et défaut de calibration des événements extrêmes. L'expertise actuarielle reste indispensable pour garantir l'équité et la stabilité financière.
L'industrie de l'assurance amorce une transition paradigmatique dans sa pratique de modélisation. Historiquement contraints par l'usage de variables structurées et de données tabulaires, les assureurs disposent désormais de capacités pour intégrer des données de haute dimension - récits de sinistres, imagerie satellite, flux de capteurs - via les Foundation Models (FM). Cet article analyse comment ces architectures, pré-entraînées sur de larges corpus de données, transforment la tarification, le provisionnement et la gestion du capital, tout en imposant un cadre de gouvernance actuarielle rigoureux.
1. L'évolution vers une modélisation multidimensionnelle
Le passage aux Foundation Models marque une rupture avec l'approche « task-specific » (spécifique à une tâche). Contrairement aux modèles classiques entraînés ab initio sur un portefeuille restreint, les FM reposent sur le pré-entraînement à large échelle. Pour l'actuaire, cette approche permet de transférer des connaissances générales (structures linguistiques, motifs géospatiaux) vers des tâches spécifiques, réduisant ainsi le besoin en historique de sinistres (experience) pour chaque nouvelle application.
L'enjeu est de transformer des sources non structurées en variables numériques ou en embeddings (représentations vectorielles). En capturant des signaux faibles, comme une complication médicale mentionnée dans une note d'expert avant qu'elle ne se traduise en flux de paiements, les FM offrent une réactivité inédite au modèle de provisionnement.
2. Typologie des modèles et des outputs actionnables pour l'actuariat
L'intégration technique des FM dépend de la nature des données sources et de la distinction fondamentale entre évaluation intrinsèque (précision de l'output du FM) et évaluation extrinsèque (contribution réelle à la tâche actuarielle). Un embedding sémantiquement parfait peut en effet échouer à améliorer la prédiction s'il n'apporte pas d'information complémentaire aux variables structurées existantes.
- Modèles de langage (LLM) : Ils extraient des variables interprétables ou des embeddings à partir des notes d'experts. En réserve individuelle, un LLM peut identifier un risque de litige ou une aggravation de blessure, permettant d'ajuster le coût ultime bien avant la dérive des triangles de liquidation.
- Modèles de vision et géospatiaux : L'imagerie (satellite ou streetview) permet une classification fine des vulnérabilités physiques (état des toitures, proximité de la végétation). Des modèles comme SatCLIP ou AlphaEarth permettent de créer des embeddings spatiaux réduisant le biais et la variance des prédictions par rapport à l'interpolation spatiale classique.
- Modèles de séries temporelles et capteurs : Des modèles tels que Chronos ou TimesFM analysent la télématique ou les capteurs domestiques. Ils facilitent la création d'indices de risque (ex: Lee et al., 2026) et la détection d'anomalies, passant d'une logique de mutualisation pure à une prévention active.
- Modèles tabulaires (TabFM) : Des architectures comme TabPFN utilisent l'inférence bayésienne approximative (Posterior Predictive Inference) pour prédire sur de petits portefeuilles. Cependant, une expertise actuarielle est requise : les recherches récentes (Deprez et al., 2026) indiquent que TabPFN ne surpasse pas systématiquement les modèles de gradient boosting (XGBoost) en tarification et s'avère nettement plus coûteux en calcul.
Synthèse des apports techniques
Type de Données Source | Output Actuariel |
Texte (Notes, rapports) | Variables interprétables (statut de litige), Embeddings sémantiques. |
Images (Satellite, dommages) | Scores de vulnérabilité physique, classification des dommages (xBD). |
Séries Temporelles (Capteurs) | Indices de comportement (télématique), prévision de flux de paiements. |
Données Tabulaires | Distributions prédictives postérieures, crédibilité augmentée. |
Documents de référence | Clauses sélectionnées, sinistres similaires (Retrieval-Augmented Generation). |
3. Le pipeline d'intégration : De la donnée brute à la décision actuarielle
Pour maintenir la rigueur prudentielle, l'intégration des FM doit suivre un pipeline structuré séparant l'encodeur (FM) du modèle de perte final. Cette séparation garantit la reproductibilité et permet de comparer l'efficacité de différents FM tout en gardant le modèle actuariel fixe.
L'architecture recommandée s'appuie sur des modèles hybrides tels que les Combined Actuarial Neural Networks (CANN) ou le LocalGLMnet. Ces cadres permettent d'insérer les outputs des FM (embeddings ou variables) dans des prédicteurs actuariels traditionnels (GLM), préservant ainsi l'interprétabilité et la stabilité des coefficients. Le processus inclut :
- Vérification pré-utilisation : Contrôle des versions et formatage des outputs.
- Filtrage de l'information : Application des restrictions réglementaires sur les variables proxies avant l'entrée dans le CANN.
- Validation extrinsèque : Mesure de l'amélioration de la calibration du modèle par rapport à un benchmark sans FM.
4. Modèles scientifiques et risques climatiques : La chaîne de transformation
L'évaluation des risques climatiques nécessite de coupler les FM avec des modèles physiques (Digital Twins) pour projeter les pertes futures. La chaîne de transformation est la suivante :
- Hazard (Aléa) : Simulation des conditions physiques (vent, précipitations) via des émulateurs météorologiques (ex: Aurora).
- Vulnerability (Vulnérabilité) : Évaluation de la résistance des actifs à l'intensité locale de l'aléa.
- Damage (Dommages) : Traduction des conditions physiques en coûts de réparation.
- Insured Loss (Pertes assurées) : Application des conditions contractuelles (franchises, limites).
La précision de cette chaîne dépend crucialement de la résolution spatiale et de la modélisation de la dépendance des pertes au sein d'un portefeuille pour l'évaluation du capital économique.
5. Gouvernance, validation et risques opérationnels
Le déploiement des FM introduit des risques quantitatifs spécifiques que le Risk Manager doit adresser :
- Biais transférés et Discrimination : Les embeddings peuvent capturer de manière latente des attributs protégés (socio-économiques). L'utilisation de graphes causaux (Côté et al., 2025) est préconisée pour détecter une éventuelle discrimination indirecte.
- Fuite temporelle (Temporal Leakage) : Au-delà du simple filtrage par date des notes de sinistres, il existe une « fuite cachée » : si un FM est pré-entraîné sur des données postérieures à la date de valorisation, il a pu « apprendre » les tendances économiques ou médicales futures.
- Incertitude et Calibration : Il est impératif de distinguer la variabilité intrinsèque des sinistres de l'incertitude sur le coût moyen (Nagler & Rügamer, 2026). Une attention particulière doit être portée à la Tail Calibration (Allen et al., 2025) pour garantir que le modèle reste fiable sur les événements extrêmes.
- Dépendance systémique : L'usage de modèles identiques (ex: via un fournisseur de Cloud unique) crée un risque de concentration. Une erreur de l'encodeur pourrait déclencher une révision simultanée des réserves à l'échelle du marché.
6. Implications économiques et structurelles du marché
L'intégration des FM modifie la dynamique concurrentielle :
- Segmentation vs Mutualisation : Une classification plus fine (ex: état réel du toit) réduit les transferts entre classes de risques, améliorant l'équité actuarielle mais pouvant poser des problèmes d'assurabilité pour les profils les plus exposés.
- Prévention et Valeur de l'Information : Le passage d'une logique réactive à une prévention basée sur les capteurs réduit la sinistralité globale. L'analyse du retour sur investissement doit se baser sur la "Valeur de l'Information" (Raiffa & Schlaifer).
7. Conclusion : Vers des modèles actuariels de fondation
L'avenir réside dans le développement d'Actuarial Foundation Models entraînés sur des données d'assurance mutualisées. Ces modèles devront résoudre le défi de la calibration après transfert : les clauses contractuelles (franchises, limites) modifient drastiquement la distribution des paiements (probabilité de zéro-paiement).
Le recours à des méthodes de prédiction conforme (conformal methods) pour ajuster les intervalles de confiance locaux et un re-modélage explicite des queues de distribution seront essentiels. L'actuaire demeure le garant de cette transformation, assurant que la richesse des données de haute dimension ne compromet ni la stabilité prudentielle ni l'équité du contrat d'assurance.