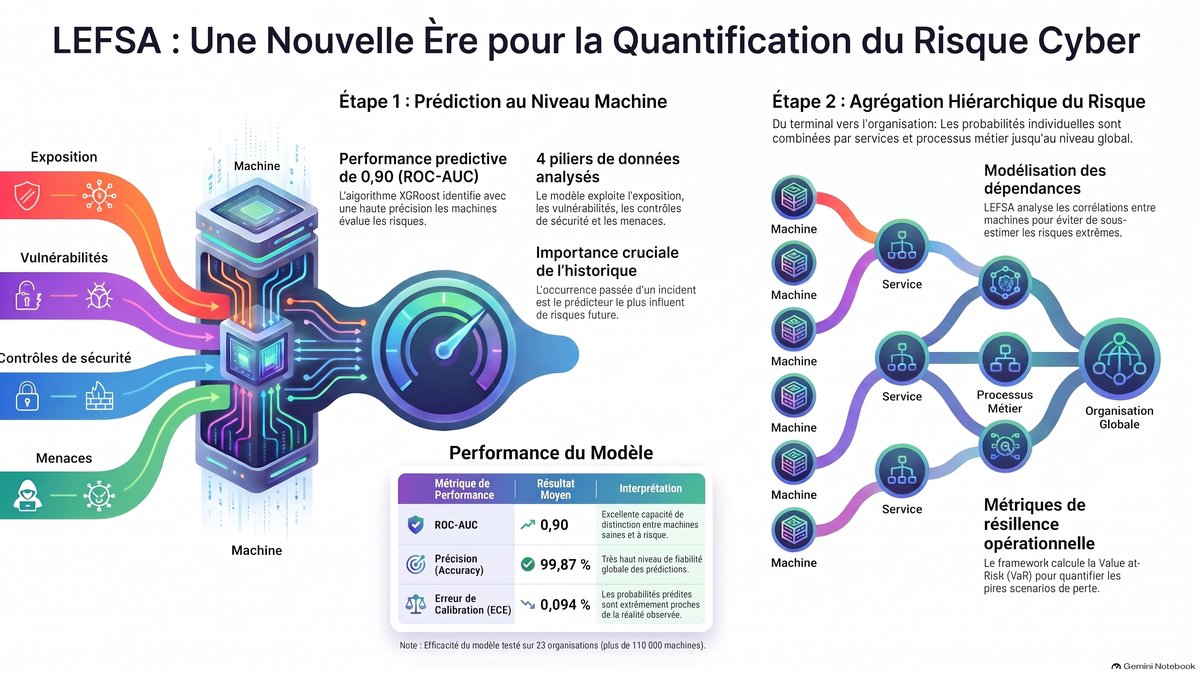
Cadre LEFSA : La modélisation stochastique au service du risque cyber
Source : Peters, S., & Eian, M. (2026). A framework to quantify the probability of future cyber loss events. arXiv.
Sommaire : Le cadre LEFSA (Loss Event Frequency Security Analyser) modernise la quantification du risque cyber (modèle FAIR) en remplaçant les scénarios subjectifs par une approche stochastique fondée sur les données.
Plutôt qu'une analyse descendante, LEFSA évalue d'abord la probabilité d'incident au niveau de chaque machine, puis agrège ces données à l'échelle de l'organisation. Pour refléter la dynamique réelle des attaques, il intègre la calibration des probabilités et prend en compte les corrélations (dépendances inter-machines) via des copules et des simulations de Monte Carlo.
Évalué sur plus de 950 000 instances, le modèle offre une grande précision prédictive et permet d'estimer efficacement le risque de queue (Value-at-Risk).
1. Introduction : Au-delà de l'approche qualitative du risque cyber
La gestion du risque cybersécurité atteint un seuil de maturité où l'intuition qualitative ne suffit plus. L'augmentation systémique de la fréquence et de la sévérité des événements de perte cyber (CLE - Cyber Loss Events) est désormais documentée : les réclamations d'assurance cyber ont bondi d'environ 40 % en glissement annuel en 2024. Parallèlement, l'intégration de l'intelligence artificielle par les acteurs malveillants accélère le cycle de vie des attaques, de la découverte de vulnérabilités à l'exploitation.
Face à cette dynamique, le cadre Factor Analysis of Information Risk (FAIR) s'est imposé comme le standard de quantification, décomposant le risque en fréquence (Loss Event Frequency - LEF) et magnitude monétaire. Cependant, l'opérationnalisation de la LEF reste souvent entravée par une télémétrie fragmentée. Le cadre LEFSA (Loss Event Frequency Security Analyser) propose de combler ce fossé en transformant les données opérationnelles granulaires en mesures probabilistes rigoureuses, passant d'une analyse par scénarios subjectifs à une modélisation stochastique fondée sur les données.
2. Présentation du cadre LEFSA (Loss Event Frequency Security Analyser)
LEFSA redéfinit l'estimation de la LEF en la formulant comme un problème de prédiction probabiliste au niveau de la machine, suivi d'une agrégation hiérarchique. Contrairement aux approches descendantes (top-down), LEFSA modélise les événements de perte à l'échelle de l'actif individuel avant de les propager à travers l'infrastructure.
Un Cyber Loss Event (CLE) est défini comme un incident de sécurité mesurable (ex: détection de malware, incident validé par un SOC). Le framework repose sur trois piliers méthodologiques :
- Prédiction probabiliste au niveau machine : Estimation de la probabilité individuelle de CLE pour chaque actif.
- Agrégation hiérarchique : Consolidation des probabilités à l'échelle des services, processus métier et de l'organisation.
- Modélisation des distributions prédictives : Capacité à simuler non seulement l'espérance mathématique, mais aussi le risque de queue (tail risk).
3. Modélisation au niveau machine : Prédiction et Calibration
Le modèle cherche à estimer la probabilité conditionnelle qu'une machine m soit impliquée dans un CLE au temps t+1, sachant l'ensemble de l'information disponible 𝓕ₜ : pₜ₊₁,ₘ := P(Xₜ₊₁,ₘ = 1 | 𝓕ₜ)
Caractéristiques et dynamique temporelle
L'ensemble 𝓕ₜ utilise quatre catégories de caractéristiques, ordonnées par leur disponibilité décroissante dans les environnements opérationnels : Exposition (E), Vulnérabilités (V), Contrôles de sécurité (SC) et Menaces (T). L'analyse révèle que le prédicteur le plus influent est le résultat décalé (lagged outcome) X_{t,m}. Cette importance souligne que le risque cyber possède des dynamiques temporelles non-memoryless, invalidant les modèles de Poisson simplistes qui supposent une intensité constante et une indépendance temporelle.
Calibration des probabilités
Pour l'agrégation stochastique, la précision prédictive ne suffit pas ; la calibration est impérative pour garantir que
P(Xₜ₊₁,ₘ = 1 | p̂ₜ₊₁,ₘ = p) = p pour tout p ∈ [0, 1]
- Modèles probabilistes (ex: régression logistique) : Visent une calibration naturelle via l'inférence par maximum de vraisemblance.
- Modèles à base de scores (ex: XGBoost) : Nécessitent souvent une cartographie de calibration post-hoc v (Scaling de Platt ou régression isotonique) telle que p̂ₜ₊₁,ₘ := v(ŝₜ₊₁,ₘ), où ŝ est le score brut.
4. Agrégation hiérarchique de l'infrastructure
L'agrégation permet de passer de la probabilité individuelle à la distribution de la variable Yₜ₊₁⁽ᵍ⁾ = ∑ₘ ∈ ₘₜ,₉ Xₜ₊₁,ₘ, représentant le nombre total de CLE pour un groupe g.
Indépendance et approximations
Sous l'hypothèse d'indépendance conditionnelle, Yₜ₊₁⁽ᵍ⁾ suit une distribution de Poisson-Binomiale. Deux approximations sont possibles :
- Approximation Normale: Via le théorème central limite de Lindeberg–Feller, si aucune machine ne domine la variance :
- Moyenne : μ̂ₜ₊₁ = ∑ₘ ∈ ₘₜ,₉ p̂ₜ₊₁,ₘ
- Variance : σ̂²ₜ₊₁ = ∑ₘ ∈ ₘₜ,₉ p̂ₜ₊₁,ₘ(1 - p̂ₜ₊₁,ₘ)
- Approximation de Poisson : Puisque les CLE sont des événements rares (p̂ₜ₊₁,ₘ ≪ 1), la distribution peut être modélisée par une loi de Poisson de paramètre λₜ₊₁ = ∑ₘ ∈ ₘₜ,₉ p̂ₜ₊₁,ₘ.
Corrélation et Copules
En pratique, le risque cyber présente une dépendance jointe (vulnérabilités partagées, contagion). LEFSA utilise des copules dynamiques pour lier les distributions marginales :
Fₜ₊₁(x₁, …, xd) = Cₜ₊₁(Fₜ₊₁,₁(x₁), …, Fₜ₊₁,d(xd); θₜ₊₁)
L'utilisation des copules pour des marginales discrètes (Bernoulli) est complexe car le théorème de Sklar ne garantit pas l'unicité de la copule, ce qui nécessite des approches par variables latentes continues ou fonctions d'inférence pour les marges (IFM).
Simulation de Monte Carlo
Pour obtenir la distribution empirique de Yₜ₊₁⁽ᵍ⁾, LEFSA génère B réalisations corrélées :
- Simuler X̃ₜ₊₁⁽ᵇ⁾ ~ F̂ₜ₊₁ pour b = 1, …, B.
- Calculer l'agrégat pour chaque simulation : Ỹₜ₊₁⁽ᵍ,ᵇ⁾ = ∑ₘ ∈ ₘₜ,₉ X̃ₜ₊₁,ₘ⁽ᵇ⁾
- . Cette méthode préserve la structure de dépendance à travers toutes les couches de l'infrastructure.
5. Analyse des résultats empiriques
LEFSA a été évalué sur 952 770 instances machine-période (23 organisations, 110 924 machines). Le jeu de données présente un déséquilibre de classe extrême avec un taux de positifs de seulement 0,134 %.
Le modèle XGBoost surpasse les autres approches, avec une performance 45 à 500 fois supérieure à un classifieur aléatoire selon la fenêtre temporelle :
Métrique | Moyenne | Médiane | Min | Max |
ROC-AUC | 0,90 | 0,91 | 0,82 | 0,95 |
PR-AUC | 0,23 | 0,22 | 0,07 | 0,37 |
Accuracy (%) | 99,87 | 99,91 | 99,75 | 99,95 |
ECE (%) | 0,094 | 0,096 | 0,023 | 0,187 |
Calibration Slope | 1,00 | 1,00 | 0,72 | 1,30 |
6. Implications pour la gestion des risques et limites
Surdispersion et risque de queue
L'étude révèle une surdispersion substantielle (37,23, p < 0,001) du nombre de CLE par rapport au modèle de Poisson-Binomial. Ce phénomène de "residual clustering" (regroupement résiduel) indique que les machines ne sont pas indépendantes. Ignorer cette dépendance conduirait à une sous-estimation critique de la variance et du risque de queue.
Grâce à la distribution prédictive, nous pouvons dériver des métriques de résilience :
- Value-at-Risk (VaR) : Le seuil de CLE non dépassé avec une probabilité α
- Expected Shortfall (ES) : La moyenne des pertes au-delà de la VaR.
Limites opérationnelles
- Biais d'étiquetage : Les CLE reposent sur les détections effectives ; les compromissions non détectées introduisent un biais systématique.
- Périmètre de monitoring : Les actifs non monitorés par les agents de télémétrie sont exclus, ce qui peut sous-estimer le risque global de l'organisation.
- Dérive conceptuelle : La performance peut se dégrader lors de changements brusques de comportement des attaquants, nécessitant un réentraînement continu.
7. Conclusion et perspectives : Vers une quantification intégrée
Le cadre LEFSA transforme la télémétrie cyber en un actif stratégique pour la prise de décision financière. En ancrant la fréquence des événements dans une réalité statistique granulaire, il offre une alternative rigoureuse aux estimations manuelles de FAIR.
Les recherches futures se concentrent sur :
- L'apprentissage fédéré : Exploiter les patterns inter-organisationnels sans compromettre la confidentialité des données.
- L'intégration de la sévérité : Coupler LEFSA à des modèles stochastiques de magnitude pour obtenir une distribution complète de la perte monétaire attendue (Annual Loss Expectancy).