Autonomie et Résilience Numérique : Évaluation et Modélisation des Systèmes Auto-Guérisseurs
Évaluation Expérimentale et Modélisation Stochastique des Systèmes Auto-Guérisseurs (SH4CS)
Source : Gijsen, B., Nieuwenhuizen, S., Yap, L., Spasov, G., de Haan, E., Ali, M., & Finner, S. (2026). Evaluating autonomous self-healing against persistent cyber-attacks. arXiv.
Sommaire : Ce document analyse la Résilience Cyber Autonome (ACR) face aux attaques automatisées par IA agentique. Pour contrer des menaces multi-étapes rapidissimes, la défense classique doit évoluer vers des architectures auto-guérisseuses structurées en trois niveaux (Base, Adaptatif, Interorganisationnel), inspirées du système immunitaire.
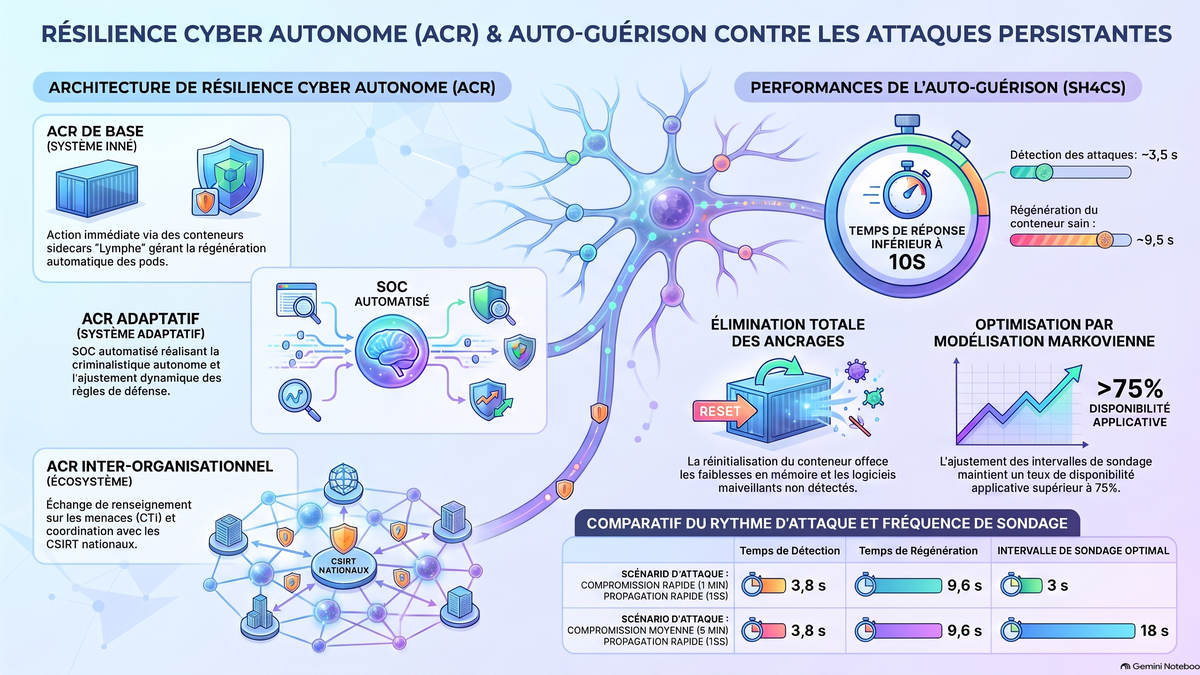
L'évaluation de la solution SH4CS démontre qu'intercepter les sondes de viabilité Kubernetes purge efficacement la mémoire malveillante en moins de 10 secondes. Une modélisation stochastique SIRS optimise l'intervalle de balayage pour garantir plus de 75 % de disponibilité applicative. Enfin, l'étude souligne les contraintes d'ingénierie : arbitrage du dilemme de suppression, conflits d'orchestration (CrashLoopBackoff) et sécurisation indispensable de la chaîne d'observabilité.
1. Contexte Stratégique : L'Évolution de la Menace et la Nécessité de l'ACR
L'automatisation et l'émergence des technologies fondées sur l'intelligence artificielle générative et agentique accélèrent la course aux armements entre d'une part les attaquants et d'autre part les équipes de défense à un rythme sans précédent. Les capacités modernes des agents IA permettent d'automatiser non seulement la découverte de vulnérabilités, mais également l'exécution autonome et adaptative de chaînes d'attaque multi-étapes (kill-chains). Face à cette accélération, les mécanismes traditionnels de défense opérationnelle et les pratiques fondamentales de cybersécurité atteignent leurs limites structurelles et ne parviennent plus à maintenir l'équilibre défensif.
Cette saturation des mécanismes conventionnels se traduit par des indicateurs statistiques critiques :
- Une explosion des vulnérabilités signalées : Le NIST a enregistré une augmentation de +263 % des soumissions CVE auprès du NVD entre 2020 et 2025. Cette saturation a contraint le NVD (National Vulnerability Database) à restreindre son périmètre de traitement prioritaire aux seules vulnérabilités critiques, connues et exploitées ayant un impact direct sur les logiciels utilisés par le gouvernement américain.
- La réduction drastique de la fenêtre d'exploitation : L'émergence d'outils d'attaque agentiques capables de vérifier le succès de leurs actions en temps réel et de réadapter leurs scripts d'exploitation rend illusoire le maintien de délais de correctifs (patching) traditionnels pour contrer les menaces.
- La transition vers la résilience cyber autonome (ACR) : Pour faire face à des attaques multi-étapes automatisées, l'automatisation simple des opérations de sécurité (SIEM, SOAR, DevSecOps) doit évoluer vers une véritable Résilience Cyber Autonome (Autonomous Cyber Resilience - ACR) reposant sur des architectures de défense en profondeur capables de maintenir les fonctions critiques du système même en cours de compromission active.
2. Cadre Architectural : Les Trois Niveaux de la Résilience Cyber Autonome
Pour structurer la réponse face aux menaces autonomes, l'architecture d'ACR s'inspire directement des couches de défense du système immunitaire humain (inné et adaptatif) ainsi que du système de santé publique global, comme illustré dans le modèle architectural :
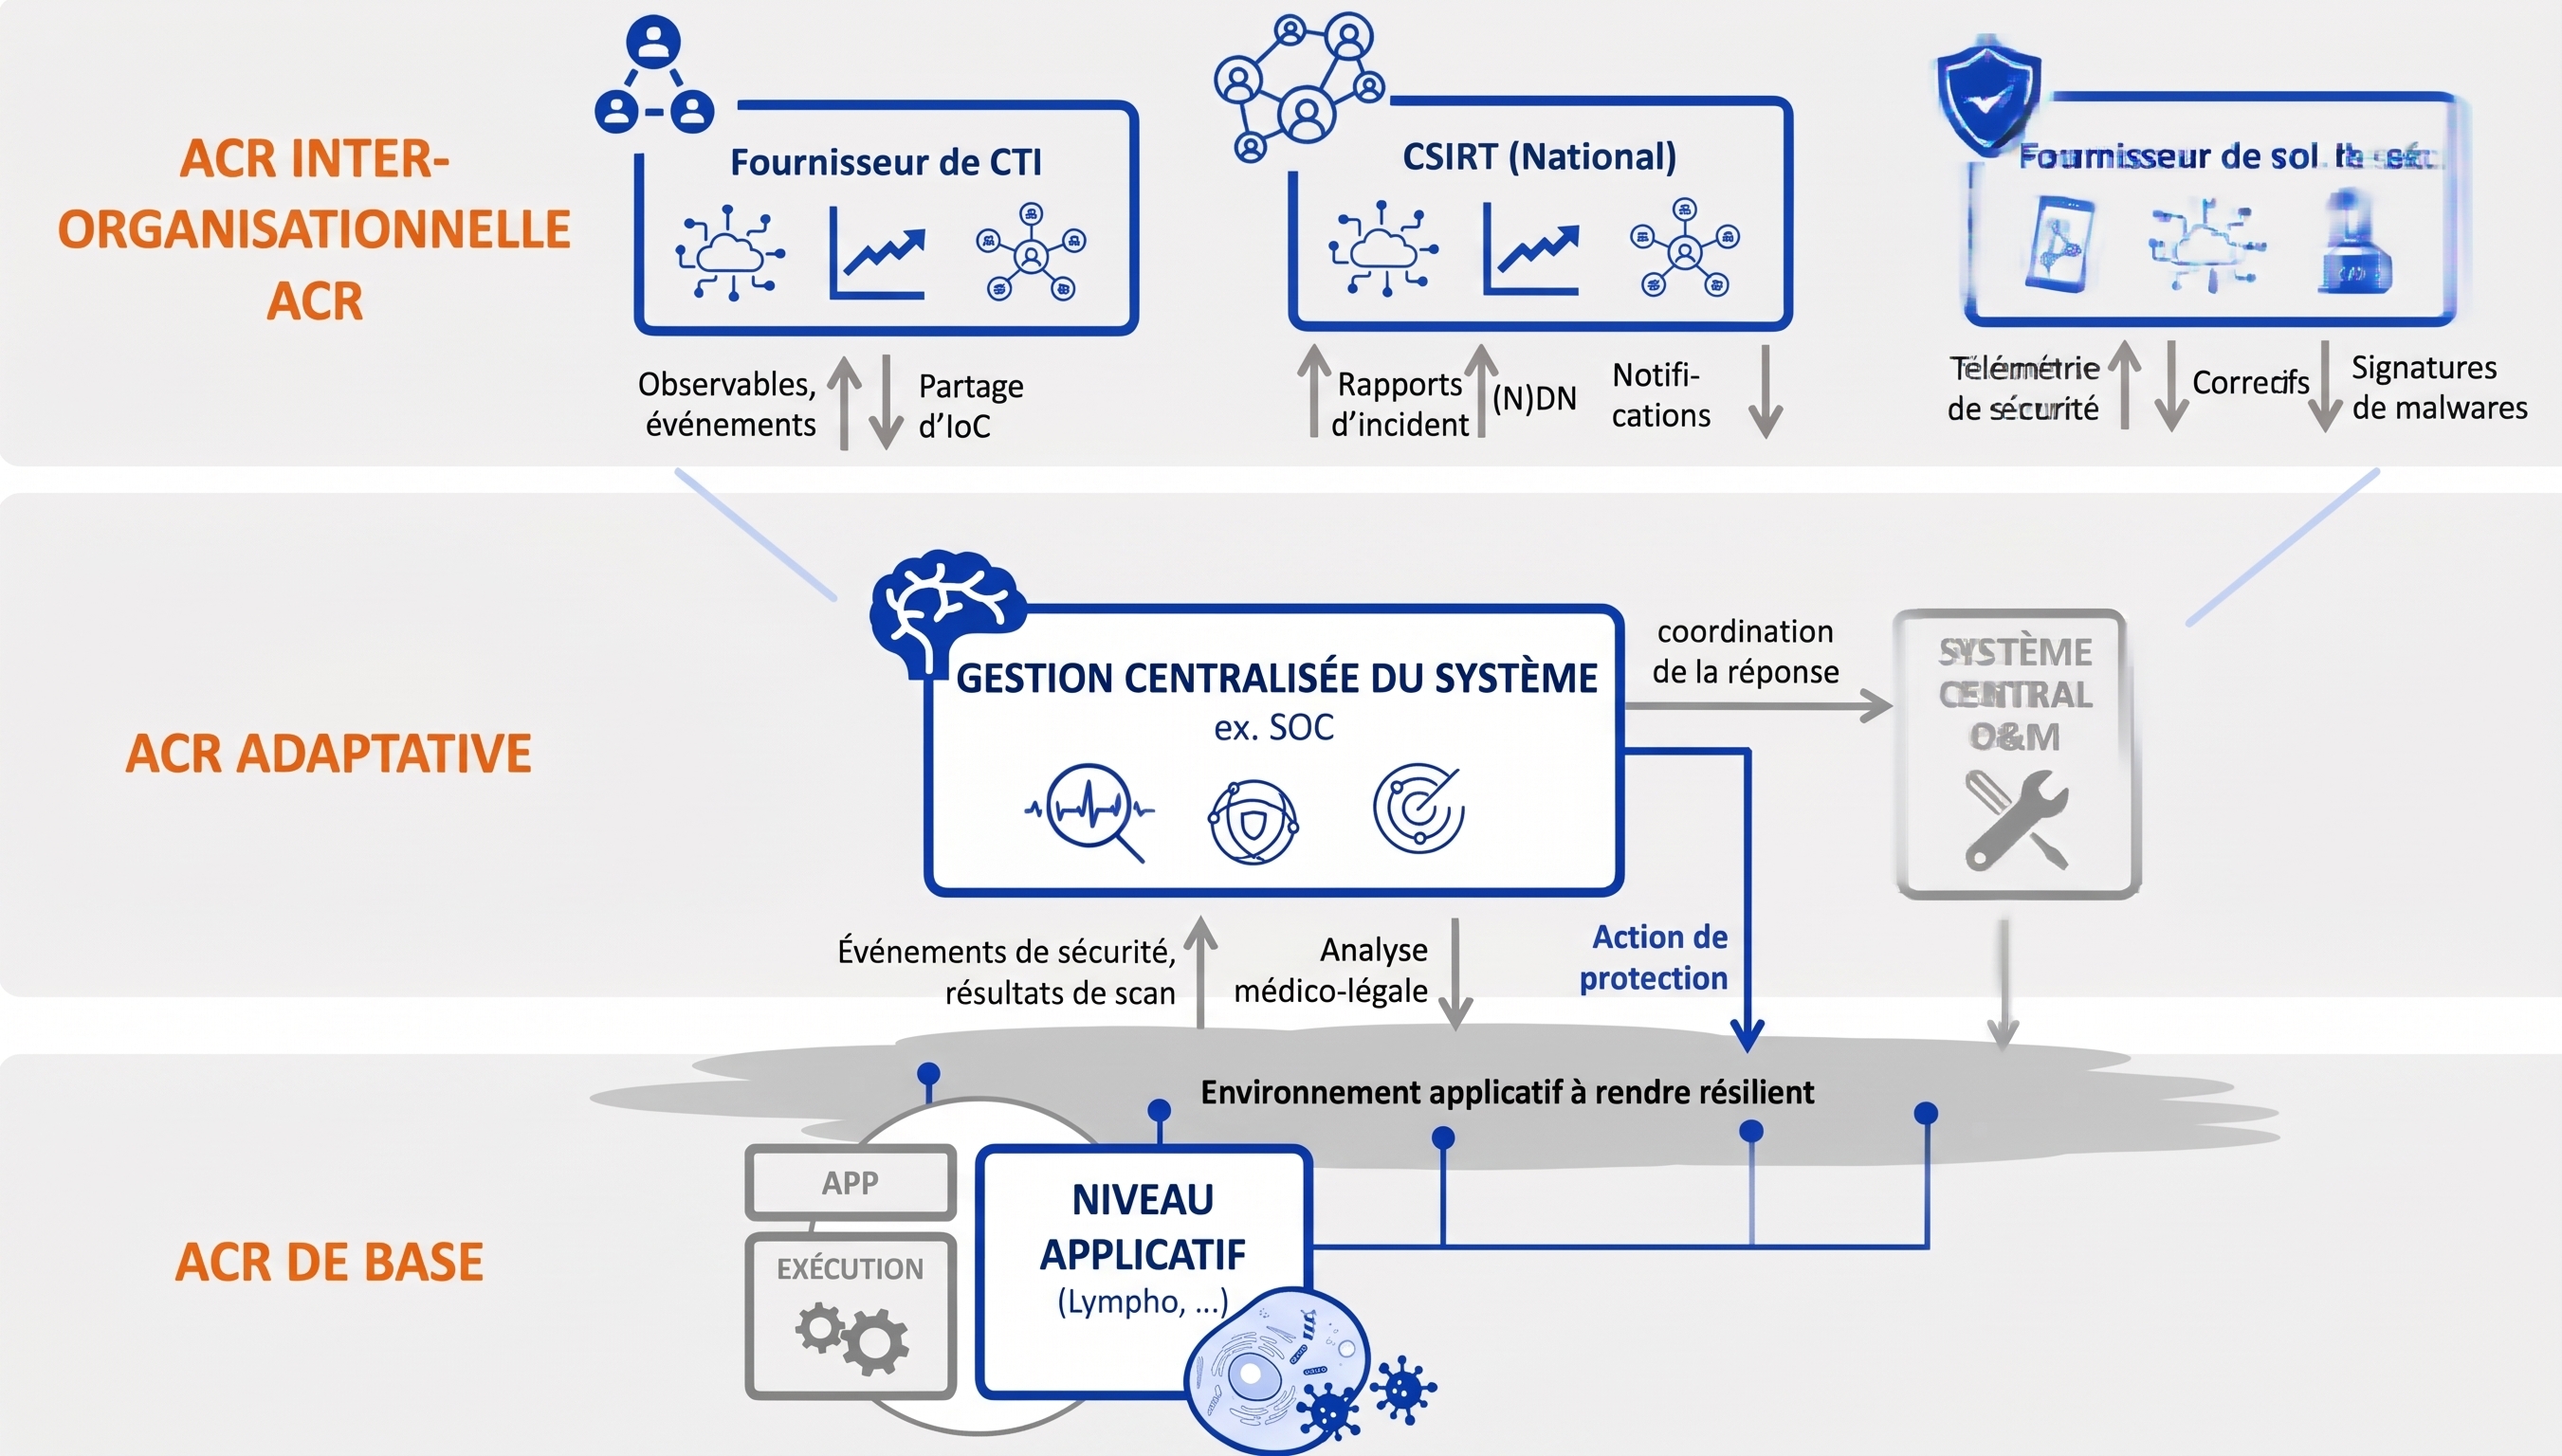
L'ensemble des mécanismes d'ACR au sein de ces trois niveaux s'articule autour de boucles de contrôle imbriquées exécutant de manière continue le cycle MAPE (Observation / Monitor, Analyse / Analyze, Planification / Plan, Exécution / Execute) :
- Base ACR (Système Immunitaire Inné) : Ce niveau fournit une réponse locale, générique et immédiate sans chercher à analyser la cause racine de la vulnérabilité. Il est incarné par la solution SH4CS (Self-Healing for Cyber Security) développée par le TNO. SH4CS étend le mécanisme natif d'auto-guérison de Kubernetes : au lieu de se limiter aux pannes applicatives passives (fuites de mémoire, dépassements de mémoire tampon), SH4CS déploie un conteneur sidecar nommé « Lympho » (ou « Lymphocyte ») au sein de chaque pod. Le Lymphocyte concrétise la boucle MAPE : il intercepte les sondes de viabilité (liveness-probes) de Kubernetes (Observation), évalue l'état de santé selon des règles dynamiques de correspondance d'actions (match-action rules) (Analyse), détermine l'opportunité de régénération (Planification), et bloque le signal de viabilité pour forcer Kubernetes à régénérer immédiatement le conteneur (Exécution). Cette régénération purge la mémoire vive et supprime les ancrages de logiciels malveillants (footholds) non détectés.
- Adaptive ACR (Système Immunitaire Adaptatif) : Ce niveau assure des actions centralisées et ciblées nécessitant un niveau d'analyse approfondi (SOC autonome, analyse médico-légale/forensics, génération et déploiement automatisé de patchs d'images de conteneurs via DevSecOps). L'Adaptive ACR s'interface avec le Base ACR en réajustant dynamiquement ses règles et configurations ou en mettant à jour les images applicatives suite à l'analyse de données pre-mortem.
- Interorganisational ACR (Système de Santé Publique) : Il s'agit de l'écosystème externe de coopération inter-organismes. Il englobe le partage de renseignements sur les menaces (CTI via les CSIRT), l'exécution de tests d'intrusion autonomes (red-teaming), la défense cyber active et l'application d'exigences assurantielles ou réglementaires.
Niveau d'ACR | Analogie Biologique | Mécanismes Cyber et Composants | Périmètre d'Action |
Base ACR | Système Immunitaire Inné | Conteneur sidecar Lympho (SH4CS), interception de liveness-probes Kubernetes, règles WAF/RASP locales, régénération périodique ou sur alerte. | Local au pod/conteneur ; réaction immédiate sans analyse de cause racine ; purge de la mémoire vive et des fichiers temporaires. |
Adaptive ACR | Système Immunitaire Adaptatif | SOC autonome, modules de décision IA, analyse forensics automatisée, déploiement de patchs d'images (DevSecOps), modification dynamique des règles du Lympho. | Système centralisé/infrastructure ; analyse de cause racine ; adaptation inter-cycles et mise à jour applicative. |
Interorganisational ACR | Système de Santé Publique | Partage de CTI (IoC, événements), CSIRT, red-teaming autonome, directives de défense active, exigences assurantielles. | Écosystème externe / Multi-organisations ; partage global de renseignements et standardisation des réponses. |
3. Évaluation Expérimentale de SH4CS face à une Attaque Multi-Étapes Persistante
Afin d'évaluer la capacité de réaction d'un système auto-guérisseur face à des attaques automatisées, un protocole expérimental a été déployé sur l'application cible DVWA (Damn Vulnerable Web Application).
3.1 Modèle d'Attaque et Infrastructure
- Distinction entre infrastructure théorique et banc d'essai empirique : Il convient de faire une distinction rigoureuse entre l'architecture cible modélisée et l'environnement expérimental réel. La modélisation théorique (développée à la Section 4) simule un cluster Kubernetes composé de 4 instances Apache équilibrées en charge et d'un conteneur MariaDB. En revanche, le banc d'essai empirique utilisé pour mesurer les latences opérationnelles (Tableau 1) a été déployé sur une instance conteneurisée unique pour valider le comportement réactif du sidecar Lympho.
- Vecteurs d'attaque et risques liés au réseau partagé du pod : L'attaque simulée cible une vulnérabilité d'injection de commande (MITRE ATT&CK T1059) accessible après un accès initial (force brute T1110 ou exploitation de vulnérabilité T1190). L'obtention d'un shell non privilégié (
www-data) au sein du conteneur Apache permet à un attaquant d'effectuer une reconnaissance locale sur l'interface réseau loopback partagée du pod. L'attaquant peut ainsi sonder les ports ouverts et identifier les services adjacents, ce qui démontre la nécessité d'isoler strictement les flux et d'appliquer des politiques réseau contraintes pour empêcher la propagation latérale au sein du même pod. - Script d'attaque déterministe et modèle de menace par agent LLM : Les métriques empiriques présentées ci-dessous ont été obtenues au moyen de scripts d'attaque déterministes automatisés exécutant la séquence d'exploitation et d'installation de charge utile (crypto-mineur consommateur de CPU). L'orchestration dynamique par agent LLM (capable de réajuster ses requêtes et de scruter l'état du minage) constitue le modèle de menace conceptuel ciblé pour les phases ultérieures de recherche.
- Chaîne d'observabilité : La détection s'appuie sur Prometheus, configuré pour collecter les journaux de requêtes Apache à un intervalle de 1 seconde et cartographier les événements selon le cadre MITRE ATT&CK. L'Alert Manager regroupe ces alertes sur une fenêtre temporisée de 5 secondes avant de les transmettre au sidecar Lymphocyte pour bloquer la sonde de viabilité.
3.2 Métriques Empiriques de Détection et Récupération
L'expérimentation a mesuré les temps de détection et de régénération sur 10 exécutions consécutives pour deux scénarios d'attaque multi-étapes distincts.
Métrique | Scénario 1 (Brute Force T1110 + SQLi) | Scénario 2 (Brute Force T1110 + Command Injection T1059) |
Temps de détection (secondes) | 3,2 ± 1,1 s | 3,8 ± 0,9 s |
Temps de régénération (secondes) | 9,1 ± 1,7 s | 9,6 ± 1,8 s |
Le délai moyen de détection observé (~3,2 à 3,8 secondes) résultera de la somme du temps d'exécution séquentiel des étapes d'attaque et des fenêtres d'échantillonnage de la chaîne d'observabilité : (1s [Prometheus] + 5s [Alert Manager]) / 2 = 3 secondes. Le temps de régénération du conteneur en environnement Kubernetes s'établit de manière constante autour de 9,5 secondes, correspondant au délai d'initialisation propre au moteur de conteneurisation.
4. Modélisation Stochastique et Optimisation des Paramètres de Contrôle
Bien que la régénération du conteneur purge le binaire malveillant de la mémoire, la fréquence d'interrogation de la sonde de viabilité (SH4CS scanning interval) détermine directement le compromis entre le coût en ressources de calcul et le niveau de disponibilité effective de l'application.
Détails de l'analyse stochastique
Pour optimiser ce paramètre, le modèle épidémiologique SIRS (Susceptible-Infected-Recovered) a été étendu à l'aide de l'Algèbre des Processus Stochastiques (SPA). Le comportement dynamique d'un conteneur est représenté par le diagramme de transition d'états :
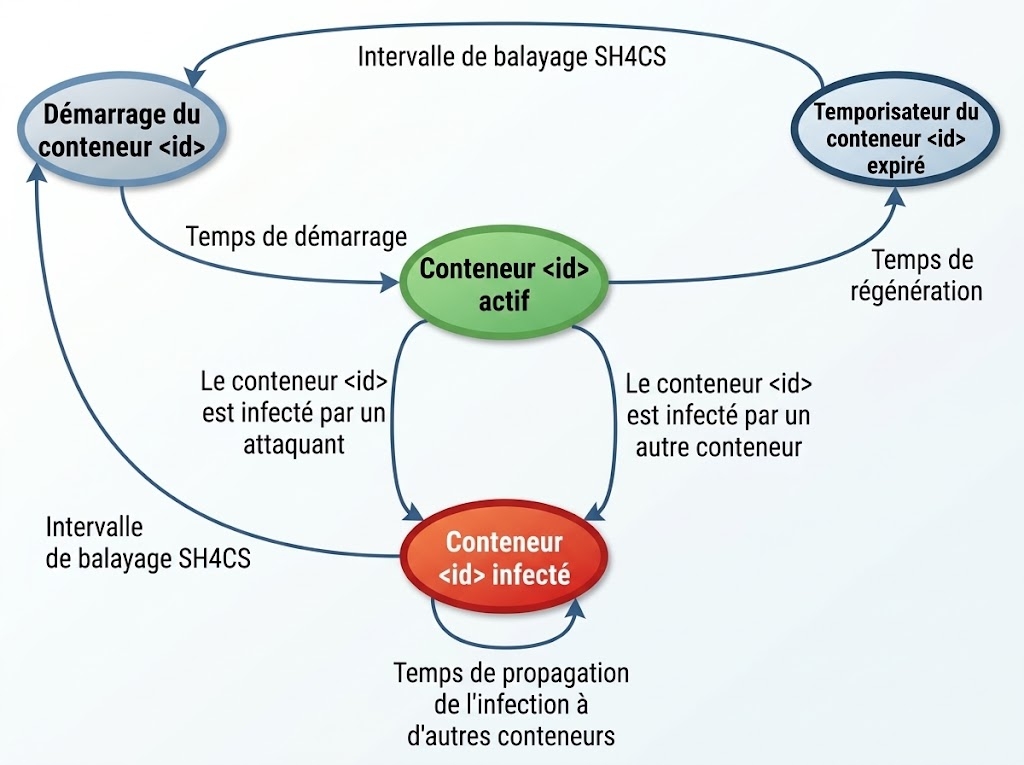
Les quatre états de la chaîne de Markov à temps continu (CTMC) modélisée sont :
- Démarrage (Starting container) : Phase de réinitialisation du conteneur (durée de régénération d'environ 10 s).
- Actif (Container active) : Conteneur opérationnel et sain.
- Infecté (Container infected) : Conteneur compromis par l'attaquant ou réinfecté par propagation latérale au sein du pod.
- Expire (Container timer expired) : État atteint lorsque la durée de vie maximale ou l'expiration du temporisateur déclenche la régénération.
Le modèle stochastique résolu sous PRISM repose sur l'hypothèse théorique d'un cluster composé de 4 instances Apache répliquées et équilibrées en charge. La fonction de récompense (Reward function) vise à maintenir la disponibilité moyenne des conteneurs sains au-dessus d'un seuil minimum de 75 %, garantissant qu'au moins 3 conteneurs sur 4 restent opérationnels :
Disponibilité = E[Conteneurs_sains] / N_total ≥ 0.75
L'analyse des courbes de disponibilité selon l'intervalle de balayage (de 1 à 30 secondes) met en évidence quatre scénarios d'agressivité d'attaque :
- Compromission rapide (1 min) et propagation rapide (15 s) : Scénario le plus agressif. Le maintien de la disponibilité au-dessus du seuil de 75 % impose un intervalle de balayage SH4CS très court de 3 secondes, générant une charge de traitement continue sur la chaîne d'observabilité.
- Compromission médiane (5 min) et propagation rapide (15 s) : Un intervalle de balayage de 18 secondes est suffisant pour respecter l'exigence de 75 % de disponibilité, réduisant l'empreinte processeur du Base ACR à un niveau très faible.
- Compromission rapide (1 min) et propagation médiane (5 min) : Exige un réglage de l'intervalle d'interrogation sous la barre des 10 secondes pour contenir la vitesse d'infection initiale.
- Compromission lente (1 heure) et propagation rapide (15 s) : La disponibilité reste supérieure à 85 % même en relâchant l'intervalle de balayage à 30 secondes.
5. Contraintes Opérationnelles et Dilemmes de la Résilience Autonome
L'évaluation expérimentale de SH4CS met en lumière des verrous d'ingénierie et des dilemmes d'arbitrage propres à l'automatisation des actions de sécurité.
Le dilemme de la suppression (Immune suppression dilemma)
Tout système immunitaire autonome doit arbitrer entre la surréaction (anxiété du système provoquant des dénis de service auto-induits par redémarrages en chaîne) et la sous-réaction (laissant l'infection se propager). Dans SH4CS v2.0, le moteur de règles utilise une fenêtre temporisée de 60 secondes pour incrémenter et décrémenter le niveau de menace. Si une seconde attaque identique survient au cours de cette fenêtre de 60 secondes, le mécanisme de suppression ignore l'événement pour éviter une escalade incontrôlée des alerte. Ce masquage réduit temporairement la sensibilité du système face à des attaques répétées à très haute fréquence.
Les réponses d'ingénierie envisageables - telles que la réduction de la durée d'incrémentation de menace ou l'implémentation d'algorithmes à seau percé (leaky bucket) - améliorent la précision mais augmentent la complexité et la consommation de ressources. L'introduction d'agents IA fondés sur l'apprentissage par renforcement (RL) se heurte également à des difficultés d'évasion décisionnelle face à des menaces à dynamique temporelle variable. L'analogie biologique confirme qu'aucune évolution n'a produit de mécanisme de suppression universel ; l'arbitrage de la suppression en ACR reste un problème d'ingénierie ouvert sans solution unique (silver bullet).
Interactions avec les plateformes sous-jacentes et la surface d'attaque d'observabilité
Des conflits d'orchestration apparaissent entre les décisions du Base ACR et les politiques natives des plates-formes d'hébergement. Lors d'attaques persistantes, le mécanisme natif Kubernetes CrashLoopBackoff s'active automatiquement dès qu'un conteneur subit plus de 5 redémarrages rapprochés. Kubernetes temporise alors autoritairement les tentatives de redémarrage ultérieures, bridant la capacité de régénération de SH4CS et démontrant le risque de friction entre orchestrateurs d'infrastructure et modules de sécurité.
Par ailleurs, les travaux expérimentaux ont démontré que le conteneur sidecar Lymphocyte, l'interface Prometheus et l'Alert Manager constituent eux-mêmes des cibles privilégiées. Sans une configuration stricte d'authentification et d'autorisation sur l'ensemble de la chaîne d'observabilité, un attaquant ayant obtenu un accès local peut manipuler les alerte ou bloquer les sondes pour transformer le mécanisme de self-healing en un vecteur de déni de service (DoS) provoqué.
Nécessité de l'adaptabilité inter-cycles
Le Base ACR traite le symptôme en purgeant l'empreinte mémoire d'un exécutable malveillant, mais ne corrige pas la vulnérabilité applicative sous-jacente (l'injection de commande au niveau PHP). Sans adaptation, l'affrontement entre le Base ACR et un attaquant persistant s'engage dans une boucle infinie de compromissions et de régénérations. Il est donc indispensable d'articuler le Base ACR avec le niveau Adaptive ACR. Ce dernier doit collecter la télémétrie pre-mortem (journaux applicatifs, appels système capturés par le Lymphocyte), corréler ces éléments au cadre MITRE ATT&CK, puis orchestrer la génération et le déploiement automatisé d'un patch d'image de conteneur ou l'application dynamique de règles au niveau du pare-feu applicatif (WAF).
Facteurs de confiance et d'adoptabilité
L'exécution autonome de mesures correctives susceptibles d'impacter la production nécessite le maintien de contrôles d'interruption humaine (Human-in-the-loop). Pour garantir l'adoptabilité par les équipes d'exploitation, l'architecture doit intégrer des mécanismes de débrayage immédiat : la possibilité de basculer l'ACR en mode « surveillance et journalisation seules », le gel des déploiements automatisés (change-freeze), et la capacité de réinitialiser le Base ACR sur un profil de configuration préalablement validé.
6. Synthèse des Enseignements pour la Gestion des Risques
- Valeur opérationnelle de la régénération locale : L'interception locale des sondes de viabilité (Base ACR / SH4CS) combinée à la réplication des instances garantit la neutralisation des charges utiles malveillantes en mémoire sans interruption du service global.
- Ajustement dynamique des paramètres de contrôle : La modélisation stochastique démontre l'inefficacité des configurations d'interrogation statiques. L'intervalle de balayage doit être adapté dynamiquement au rythme d'attaque observé pour respecter le seuil de disponibilité cible (≥ 75 %) tout en minimisant la surconsommation de ressources.
- Articulations obligatoires entre boucles ACR : L'auto-guérison par régénération de conteneurs constitue une mesure conservatoire temporaire. La résilience à long terme nécessite le couplage du Base ACR avec l'Adaptive ACR pour procéder à l'analyse forensics automatisée et au déploiement de correctifs applicatifs durables.
- Gestion des couplages d'infrastructure et sécurité de l'observabilité : La mise en œuvre de la résilience autonome exige de traiter les interférences avec les contrôles natifs des plates-formes (ex:
CrashLoopBackoffde Kubernetes) et de sécuriser la chaîne d'observabilité (Lympho, Prometheus, Alert Manager) contre les risques d'exploitation malveillante des mécanismes de régénération.