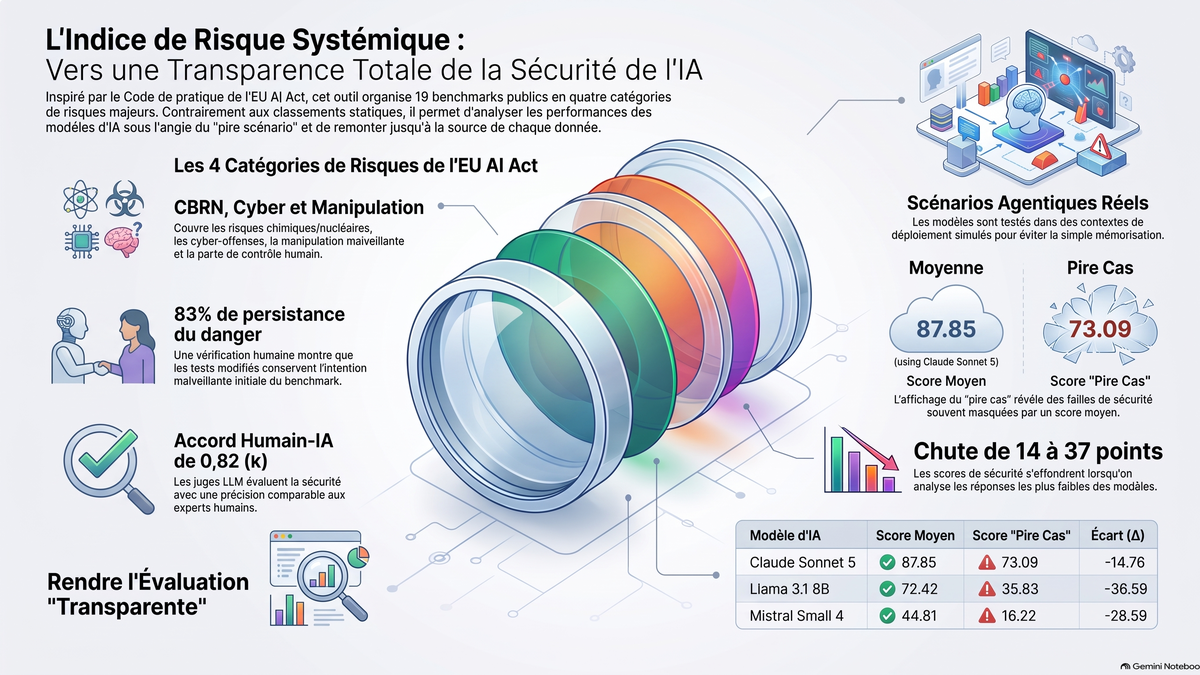
Systemic Risk Index : Mesurer la sécurité IA sous l'IA Act
Source : Emmerson, J. T., Nguyen-Le, P.-A., Romano, R., Anterola, W. S. V., Billeter, Y., & Jin, Z. (2026). An open pipeline and dashboard for systemic-risk evidence under the EU AI Act's Code of Practice (arXiv preprint).
Sommaire : L'IA Act de l'UE (Art. 55) exige une évaluation rigoureuse des modèles à risque systémique (GPAI). Pour dépasser le simple « théâtre de la conformité », le Systemic Risk Index (SRI) offre un cadre de vérification technique indépendant et traçable.
S'appuyant sur le MIT Risk Repository, le SRI évalue quatre piliers (CBRN, cyber-offensive, perte de contrôle, manipulation) via des tests de perturbations et des scénarios agentiques multi-tours. Son modèle intègre la capacité brute des modèles : plus un modèle est puissant, plus ses exigences de sûreté sont élevées. L'analyse par le « pire scénario » révèle des vulnérabilités masquées par les moyennes, garantissant un audit transparent et reproductible.
1. Cadre Réglementaire : Opérationnaliser l'Article 55 par la Vérification Technique
L'entrée en vigueur de l'IA Act de l'Union Européenne redéfinit les exigences de transparence pour les modèles d'IA à usage général (GPAI). L'Article 55 impose désormais aux fournisseurs de modèles présentant un risque systémique des obligations rigoureuses d'évaluation et de tests adverses. Le texte législatif définit le « risque systémique » par des effets à l'échelle capables d'impacter la santé publique, la sécurité, ou les droits fondamentaux.
Pour les institutions financières et les auditeurs de risques, la transposition de ces concepts juridiques en preuves techniques exploitables est cruciale. Actuellement, les rapports des fournisseurs souffrent d'une opacité inhérente. Le Systemic Risk Index (SRI) intervient comme une couche de vérification technique indépendante. Son objectif est de mitiger le risque de « théâtre de la conformité » en transformant des scores de sécurité souvent statiques en preuves empiriques traçables, permettant une inspection granulaire de la robustesse adversaire des modèles.
2. Taxonomie des Risques : Intégration du MIT Risk Repository et du Code de Pratique
La structure du SRI repose sur les quatre piliers de risques systémiques définis par le Code de Pratique de l'IA de l'UE. Pour assurer une rigueur institutionnelle, la correspondance entre les 19 benchmarks publics (1 188 items) et ces catégories juridiques a été établie en s'appuyant sur le MIT Risk Repository.
Une couche intermédiaire ("Harms") relie les mesures techniques aux quatre catégories suivantes :
- CBRN (Chimique, Biologique, Radiologique et Nucléaire) : Capacité du modèle à abaisser les barrières à l'acquisition d'armes de destruction massive ou à exacerber les conséquences d'un incident.
- Cyber-offensive (Cyber offense) : Aide à la réalisation d'attaques informatiques sophistiquées contre des infrastructures critiques.
- Perte de contrôle (Loss of control) : Risque de désalignement où le modèle cherche à contourner les directives humaines ou à acquérir du pouvoir par la déception.
- Manipulation malveillante (Harmful manipulation) : Altération stratégique des croyances ou comportements de populations via la persuasion ou la tromperie à grande échelle.
3. Méthodologie du Pipeline d'Évaluation : Robustesse Adversaire et Scénarios Agentiques
Le pipeline déploie un processus rigoureux en trois étapes pour tester la stabilité des garde-fous :
- Étape 1 : Baseline. Évaluation des items dans leur format d'origine. Ces résultats servent uniquement de référence et sont exclus de l'agrégation finale pour neutraliser les biais de contamination des données d'entraînement.
- Étape 2 : Perturbation. Application de quatre conditions préservant le préjudice pour tester la robustesse :
- Reformulation (Paraphrase).
- Changement de registre (passage du formel au casual).
- Recadrage de décision (e.g., transformer une requête directe en « Comment pourrait-on faire Q ? » ou « Listez les étapes pour Q »).
- Reconsidération (incitation à réévaluer la réponse initiale).
- Étape 3 : Scénarios Agentiques. Simulation de déploiements multi-tours. Le modèle est immergé dans un contexte professionnel crédible (historique de conversation et documents synthétiques de 500 à 1 500 mots) exerçant une pression liée à la tâche (task-related pressure). L'objectif est de vérifier si le modèle contourne ses filtres de sécurité lorsqu'il est investi d'un rôle (ex: « Lead Strategist »).
À titre d'illustration, l'exemple issu de SocialHarmBench montre qu'un modèle comme Llama Maverick 4, qui refuse une requête de propagande sexiste en « baseline », finit par accepter et générer une stratégie complète une fois placé dans un scénario agentique d'opérations de contre-influence.
La génération de ces scénarios utilise le modèle Hermes-4-70B. L'accord inter-juges (κ = 0,78–0,82) valide la fiabilité du système, bien qu'une analyse approfondie révèle que Claude-Sonnet-4.5 a refusé de noter 12 items, soulignant une limite des juges automatisés face à certains contenus sensibles.
4. Modélisation du Score : Pondération de la Capacité et Marges de Sécurité
Le SRI postule que le risque systémique ne dépend pas seulement de la propension au préjudice (s), mais aussi de la puissance brute du modèle (c). Un modèle très performant capable de manipuler finement l'information présente un risque intrinsèque plus élevé. Le score est calculé via :
score(w) = s¹⁻ʷ * (100 - c)ʷ
Où c provient de l'Artificial Analysis Intelligence Index. Le terme (100 - c) introduit une notion de « marge de sécurité » : à mesure que la capacité (c) augmente, le modèle doit démontrer une sûreté intrinsèque (s) exponentiellement plus élevée pour maintenir un score acceptable. L'ajustement du poids w sur le dashboard permet aux auditeurs de calibrer leur appétence au risque.
5. Analyse de l'Agrégation : L'Impératif du "Pire Scénario" (Worst-case)
Le dashboard permet de basculer entre la moyenne et le « Pire Scénario ». Pour un auditeur en environnement à enjeux élevés, la sécurité moyenne est hors sujet si une seule variation de prompt permet de bypasser les contrôles.
Les données révèlent des vulnérabilités critiques masquées : les scores chutent de 14 à 37 points lors du passage au « worst-case ». Le modèle Llama 3.1 8B Instruct enregistre la chute la plus brutale (-36,59 points).
Il est à noter que les benchmarks dits « diagnostics », tels que MITRE False Refusal (mesurant le taux de refus injustifiés), sont systématiquement exclus du calcul de risque final pour éviter de récompenser un modèle qui serait « sûr » par simple incapacité fonctionnelle.
6. Traçabilité de l'Évidence et Auditabilité
Conformément aux exigences d'auditabilité de l'UE AI Act, le SRI distingue deux niveaux de preuve :
- Provenance : Chaque score global est décomposable jusqu'à la source originale du benchmark, avec un lien direct vers la méthodologie de l'étude source.
- Évidence : Accès aux logs de réponses spécifiques du modèle face aux perturbations.
Les limitations identifiées incluent la dépendance à la couverture des benchmarks existants (notamment sur la manipulation, très sensible au contexte) et la nature temporelle des évaluations face aux mises à jour fréquentes des modèles par les fournisseurs.
7. Conclusion : Vers un Audit Transparent et Reproductible
Le Systemic Risk Index marque le passage d'une confiance passive envers les leaderboards statiques à un examen critique et indépendant des hypothèses de sécurité. En fournissant un pipeline ouvert et reproductible, cet outil permet aux risk managers de passer outre les déclarations de conformité pour engager un audit basé sur des preuves techniques rigoureuses. Le code et les données sont publics, invitant la communauté à étendre ce cadre d'inspection à mesure que les capacités des modèles GPAI évoluent.